この記事には広告(Amazon アソシエイトのリンク)を含みます。
Anthropicが2026年9月に入ってすぐ、Claudeの最上位モデル「Claude Fable 5.1」を公開しました。今年6月に出たばかりの「Claude Fable 5」の後継です。3か月弱での更新なので、名前のとおり世代交代ではなくマイナーアップデートに見えます。ただ、公式の発表資料を読んでいくと、性能表の数字よりも料金の仕組みのほうがよほど大きく変わっていることが分かりました。この記事では、公式発表と開発者向けドキュメントをもとに、5と5.1で何が同じで何が違うのかを整理します。
Fable 5とFable 5.1は同じ土台のモデル
まず前提として、Fable 5.1はFable 5を別のアーキテクチャに置き換えたものではありません。開発者向けドキュメントでは「Fable 5を拡張したもの」という書き方で、入力と出力の基本料金、コンテキストウィンドウ(100万トークン)、最大出力(128Kトークン)、トークナイザー、思考の深さを調整するeffortパラメータはすべてFable 5と共通です。多言語性能もFable 5と同等とされています。
もうひとつ、ややこしい名前の話を整理しておきます。今回は「Claude Fable 5.1」と「Claude Mythos 5.1」が同時に発表されましたが、この2つは同じモデルです。違いは安全機構のレベルだけで、Fable 5.1が一般提供版、Mythos 5.1はサイバーセキュリティや生命科学の分野で審査を通った組織だけが使える版です。Fable 5とMythos 5の関係も同じでした。この記事では一般に使えるFableのほうを中心に見ていきます。
ベンチマークはたしかに上がっている
Anthropicが公開している比較表を見ると、数字の伸びは分野によってかなり差があります。
いちばん大きく動いたのは科学研究の自律作業を測る「Terminal-Bench-Science 0.1」で、Fable 5の24.7%からFable 5.1は52.6%と2倍以上になりました。業務ワークフローの自動化を測る「AutomationBench」も17.1%から31.4%です。エージェント型コーディングの「Terminal-Bench 4.0」は42.0%から55.8%に伸びています。
一方で、総合的な知識を問う「Humanity’s Last Exam」はツールなしで57.8%から60.9%、コーディングの「CursorBench 3.2.0」は70.5%から73.4%と、こちらは数ポイントの差にとどまります。
つまり伸びたのは、何時間も動き続けて自分で検証しながら進める長い作業のほうで、一問一答に近いタスクではそれほど変わっていません。Anthropic自身も、effortを「Low」や「Medium」に下げた5.1はFable 5と同等かやや上の結果を安いコストで出す、と説明しています。ちなみにClaude.aiでの既定値はMediumなので、チャット画面で普通に使う分には、Fable 5との差は体感しにくいはずです。
先行して試した企業のコメントも、長時間の無人実行やコードベース全体の調査、契約書の修正、スライド生成といった重めの作業での改善を挙げるものが目立ちます。投資会社のMillenniumは、100万回に1回程度しか起きないクラッシュの原因を、Fable 5を含む他のモデルが見つけられなかったのにFable 5.1が突き止めた、と報告しています。
値下げの正体は「キャッシュ読み取り」だけ
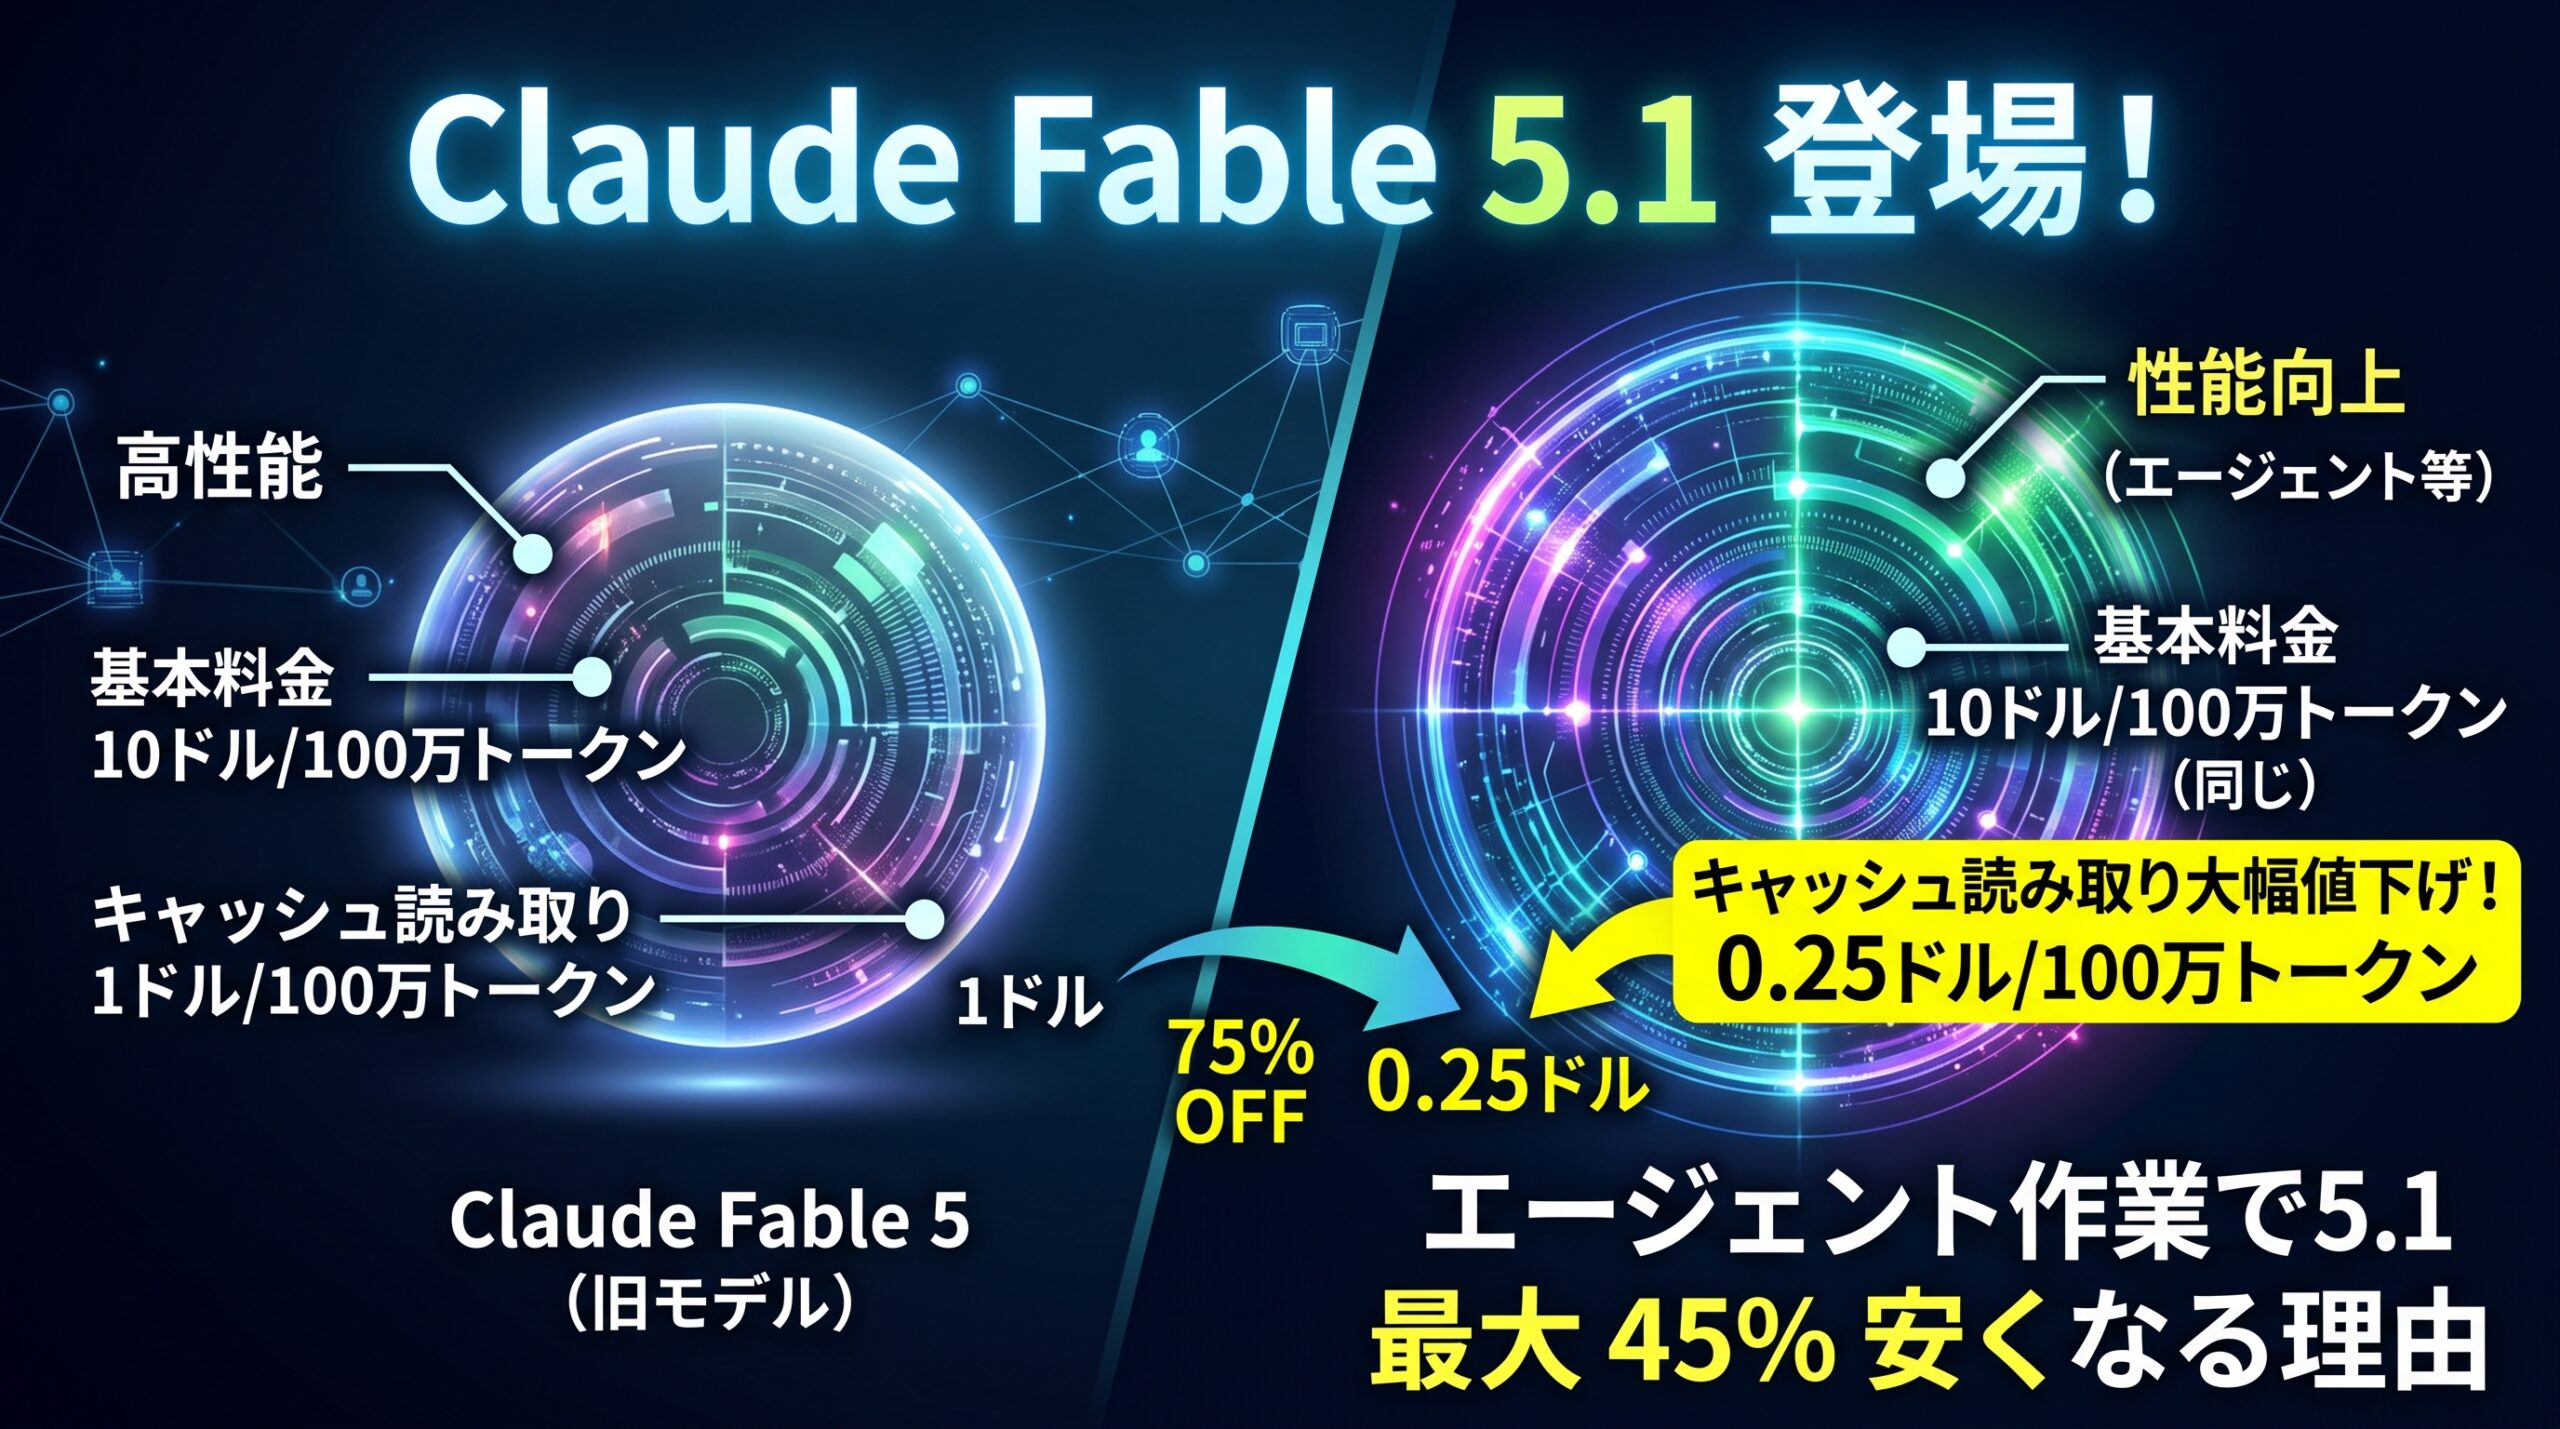
ここからが今回いちばん意外だった点です。Anthropicは「Fable 5.1は一般的なワークロードで約25%、エージェント型の重い作業では最大約45%安くなる」と発表しています。ところが料金表を見ると、入力100万トークンあたり10ドル、出力100万トークンあたり50ドルという基本料金は、Fable 5から1セントも変わっていません。
変わったのは「キャッシュ読み取り」の単価だけです。これは、一度処理した入力(システムプロンプト、ツール定義、読み込んだ文書、それまでの会話履歴など)をモデルが再利用するときの料金で、Fable 5では100万トークンあたり1ドルでした。Fable 5.1では0.25ドルと、75%引きになっています。
これで全体が25〜45%安くなるのは、AIエージェントの動き方に理由があります。エージェントは1回の作業のなかで同じコードや文書、会話履歴を何度も読み返します。ツールを呼ぶたびに、それまでの文脈を丸ごと読み直すからです。Anthropicが2026年8月の4週間の実利用データから出した内訳では、重いエージェント作業ではコストの大半がこのキャッシュ読み取りで占められていました。だから、そこだけ値下げしても効果が大きい、という構図です。
逆にいえば、短い質問を1回投げて答えをもらう使い方では、キャッシュ読み取りがほとんど発生しないので、料金はFable 5とほぼ変わりません。性能の伸びと同じく、値下げの恩恵も「長い作業をさせる人」に偏って届く設計になっています。
API利用者が気をつけたい変更点
開発者向けドキュメントには、Fable 5から移行するときに動かなくなる変更が3つ挙げられています。
1つめは「強制ツール使用」がエラーになること。特定のツールを必ず呼ばせる指定(tool_choiceの「any」や「tool」)は使えなくなりました。Fable 5.1は思考が常時オンで、ツール呼び出しを強制すると思考を飛ばしてしまうため、というのが理由です。
2つめは、Fable 5.1が出した思考ブロックを古いモデルが読めないこと。5.1から別のモデルに切り替えると、そのぶんの推論は引き継がれません。逆方向(古いモデルから5.1へ)は問題ありません。
3つめは、会話の途中の発言を後から書き換えると、それ以降の思考ブロックが無効になること。これは蒸留(他社が大量のアカウントを使ってモデルの能力を抜き取る手法)への対策として入ったもので、2026年8月31日以降に作られた新規アカウントから適用されています。
コードを変えなくても挙動が変わる点もいくつか書かれています。長いエージェント作業で、Fable 5がまとめて実行していたツール呼び出しを1回ずつ行うことがある、作業中の進捗報告が減る、文章がところどころ密になる、チャットでの太字や見出しの使用が減る、ファイルの小さな修正で全体を書き直しがちになる、といったものです。文章を書かせる用途なら、太字や見出しが減る点と、文が詰まりがちになる点は覚えておいて損はないと思います。
安全機構は緩くなったのか
Fable 5は、危険な用途を止める分類器が誤って無害な質問まで止めてしまう、という不満が出ていたモデルでした。今回はそこも手が入っています。
サイバーセキュリティ分野では、安全機構の誤検知が以前より60%減り、Claude Codeのセッションあたりの介入回数も約60%減る見込みとされています。ソフトウェアの脆弱性を「見つける」用途は許可されるようになりました。ただし、見つけた脆弱性を攻撃に使うコードの生成や侵入テストは引き続き制限され、Opusモデルに振り向けられます。
生物学分野では、基礎的な生物学や医療の質問に対する誤検知が85%減ったとされていますが、こちらは研究開発レベルの質問は引き続きOpusに回されます。専門家向けにはMythos 5.1へのアクセスプログラムが米国政府と共同で用意されていて、現時点では米国内の組織に限られています。
もうひとつ、目立たない変更として、Fable 5.1が生成した文章には統計的な透かしが入るようになりました。EUのAI法にもとづく取り組みで、文章の見た目や内容には影響せず、利用者の情報も含まれませんが、検出用のAPIを持つ組織であればClaudeが関与した文章かどうかを推定できます。検出APIは現時点では規制当局や報道機関、研究者など限られた組織向けの先行提供です。
どちらを使うべきか
Anthropicのドキュメントは、ほとんどの用途ではまずClaude Opus 5から試し、Opus 5でeffortを上げても足りない場合にFable 5.1を選ぶ、と案内しています。Fable 5.1は最上位モデルですが、万能の既定値として推されているわけではありません。
Fable 5をすでに使っている場合は、基本料金が同じで性能が上がり、長い作業ほど安くなるので、5.1に移す理由はそろっています。移行時に確認が必要なのは、上に挙げたAPIの3つの変更だけです。
チャットで使う人にとっては、体感の差は小さいと思います。今回の更新の中心は、何時間も動かすエージェント作業の性能と料金で、そこを使い込む人ほど変化が大きく、一問一答で使う人ほど変化が小さい。そういう更新でした。Anthropicは今回の改善を他のモデルにも順次広げていくとしているので、Opus 5やSonnet 5にキャッシュ読み取りの値下げが来るかどうかは、しばらく見ておきたいところです。
関連する商品
この記事に関連する本や商品は、Amazon で探せます。
上のリンクから購入されると、このブログに紹介料が入ることがあります。
画像について
この記事の画像は AI(ChatGPT)で作った想像図で、ご自由にお使いいただけます。お使いになるときは、出典としてこの記事へのリンクを載せていただけるとうれしいです。
参考
Introducing Claude Fable 5.1 and Claude Mythos 5.1(Anthropic)
コメント