この記事には広告(Amazon アソシエイトのリンク)を含みます。
人と話しているとき、口から出ている言葉だけで会話が成り立っていることは、ほとんどありません。「うん」と言いながらうなずく。「さあね」と言いながら肩をすくめる。「やあ」と言いながら手を振る。言葉と身ぶりは、ふだん意識しないまま同時に出ています。
脳の信号を読み取って言葉を取り出す技術(BCI=ブレイン・コンピュータ・インターフェース)は、この数年でずいぶん進みました。話せなくなった人の脳活動から文章を組み立てたり、合成音声で読み上げたり、カーソルやロボットアームを動かしたりといった報告が続いています。ただ、そのほとんどは「話す」か「動かす」かのどちらか一つを扱ったものでした。両方を同時に、しかも一つの装置で読み取れるのかという問いには、これまではっきりした答えがなかったわけです。
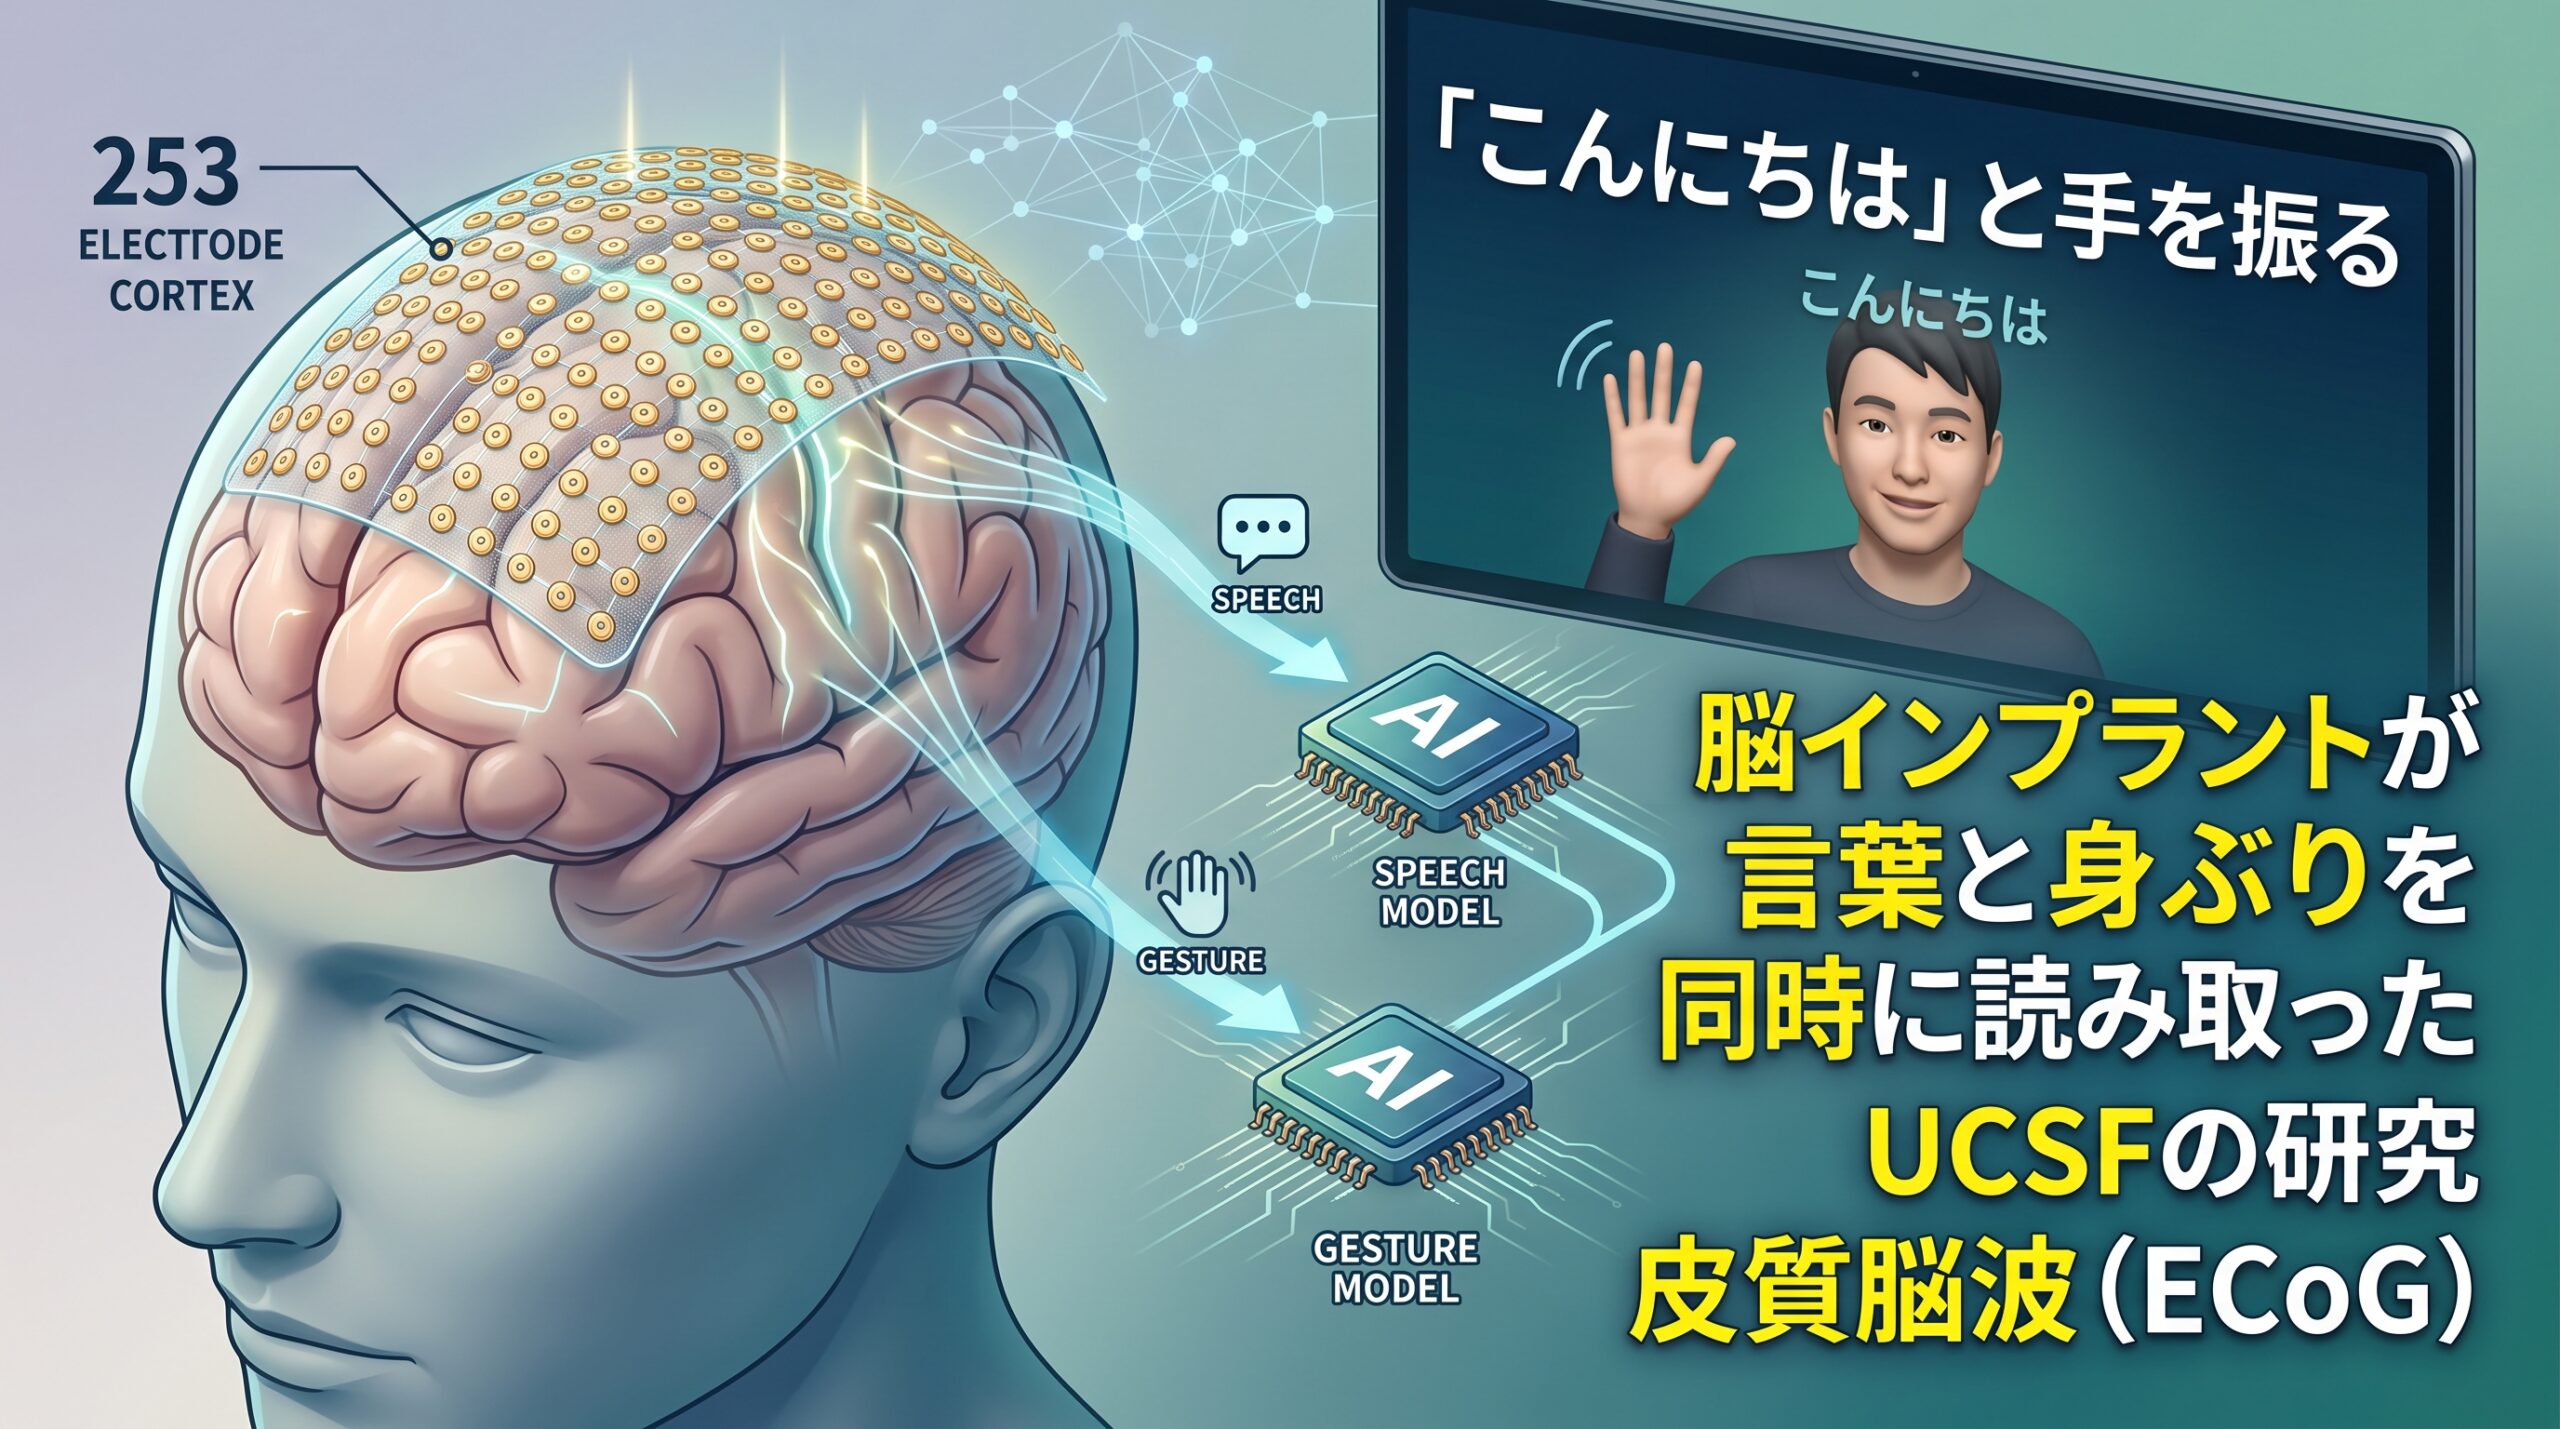
2026年9月14日、カリフォルニア大学サンフランシスコ校(UCSF)のチームが、その答えを出す研究をNature Neuroscienceに発表しました。話そうとした言葉と、しようとした身ぶりを、一つの脳インプラントから同時に読み取り、言葉は文字として、身ぶりはアバターの動きとして、リアルタイムで出力したという内容です。
脳の表面に置いた253個の電極
使われた装置は、253個の電極を3ミリ間隔で並べた薄いシートです。手術で脳の表面(左半球)に直接置き、頭に固定したコネクターを通じて外の機器に信号を送ります。脳の中に針を刺すタイプではなく、表面に貼るタイプで、この方式は「皮質脳波(ECoG)」と呼ばれます。
ポイントは、このシートが覆っている範囲の広さです。脳の「感覚運動野」と呼ばれる帯状の領域には、顔や口を動かす担当の場所、手や腕を動かす担当の場所、頭や目を動かす担当の場所が、だいたい並んでいます。253個の電極はこの帯をまとめてカバーしているので、一枚のシートで「話す」ための信号と「手を動かす」ための信号の両方を拾えます。研究チームはまず、3人の参加者でこの点を確かめました。手・腕・顔・頭・目など、体のいろいろな部分を動かそうとしたときの脳活動が、それぞれ区別できる形で記録されていたそうです。
2人の参加者と、それぞれの試し方
本題の「言葉と身ぶりの同時読み取り」に参加したのは、このうちの2人です。
1人目は、20歳のときに脳幹の脳卒中を起こし、以来、体の大部分がまひして、はっきりした発声もできなくなった男性です。ふだんは頭のわずかな動きで文字を選ぶ機器を使って会話しています。この人は、声を出さずに言葉を言おうとし、身ぶりはごく小さく試みる、というやり方で参加しました。言葉は5つの言い回し、身ぶりは「手を振る」「うなずく」「手を揺らす」「拍手」の4つです。
2人目は、56歳でALS(筋萎縮性側索硬化症)と診断された男性で、参加時は60歳。話す力を失っていますが、腕はまだ動くので、指先の細かい動きは難しいながらもスマホやパソコンで文字を打って会話しています。この人は、声を出して(といっても聞き取れる言葉にはならない状態で)話そうとし、身ぶりは体を動かさずに「頭の中で思い浮かべる」だけ、という条件でした。言葉は10の言い回し、身ぶりは「肩をすくめる」「親指を立てる」などの10種類です。
参加者の状態が違うので、試し方も違います。そのため、この2人の結果を単純に並べて比べることはできません。研究チームもその点は最初から断っています。
別々に学習させたAIは、同時にやると読めなかった
ここからがこの研究のいちばん面白いところです。
脳の信号を言葉や身ぶりに変換するのはAIのモデルで、言葉用と身ぶり用の2つが並行して動きます。素直に考えれば、「言葉だけ」のデータで言葉用モデルを学習させ、「身ぶりだけ」のデータで身ぶり用モデルを学習させて、あとは2つを同時に走らせれば済みそうです。
ところが、そうはいきませんでした。「言葉だけ」「身ぶりだけ」で学習したモデルを、「言葉と身ぶりを同時に試みた」ときの脳信号にあてはめると、精度がはっきり落ちたのです。
理由は、脳の中で「話す」ための信号と「手を動かす」ための信号が、きれいに分かれていなかったことにあります。電極の一部は言葉のときだけ、一部は身ぶりのときだけ反応しましたが、両方に反応する電極もそれなりの数ありました。しかも、2つを同時にやろうとすると、脳活動のパターンそのものが、片方だけのときとは少し違う形になります。片方だけのデータで学習したモデルは、その「同時のときの形」を見たことがないので、うまく読めなかったというわけです。
解決策は、ある意味で単純でした。「言葉だけ」「身ぶりだけ」のデータに加えて、「同時にやったとき」のデータも混ぜて学習させる。こうすると、モデルは単独のときも同時のときも、どちらもそれなりの精度で読めるようになりました。学習のさせ方を変えると、モデルが重視する電極の場所も変わっていて、両方に反応する電極への依存が減り、片方にしか反応しない電極をより頼るようになっていたそうです。
もう一つ、地味ですが大事な工夫があります。言葉用のモデルは、参加者が身ぶりだけをしようとしたときには「何もしない」と判断しなければいけません(逆も同じです)。ところが、最初の学習のままだと、身ぶりだけのつもりなのに言葉用のモデルが勝手に反応してしまう「誤作動」が多く、1人目の参加者では76%の割合で起きていました。そこで、身ぶりだけのデータを「言葉としては休止」という正解ラベルで言葉用モデルに覚えさせる、という追加の学習をしたところ、この誤作動は両参加者ともほぼ0%まで下がりました。
文字とアバターが同時に動いた
こうして学習したモデルを、実際にリアルタイムで動かしたのが今回の主な結果です。画面には参加者本人に似せた全身のアバターが表示され、読み取った言葉は画面下に文字で出て、読み取った身ぶりはアバターが実際に演じます。「こんにちは」と手を振る、「はい」とうなずく、といった組み合わせがそのまま画面に現れる形です。
精度はどのくらいだったのでしょうか。事前に集めたデータで評価した「同時」の読み取り精度は、2人目(10種類ずつ)で身ぶり69%、言葉78%。1人目(4種類と5種類)で身ぶり88%、言葉84%でした。当てずっぽうで当たる確率がそれぞれ9%前後、17〜20%であることを考えると、はっきり読めています。
リアルタイムでの試験でも、2人目が言葉と身ぶりを同時に試みた場面で、身ぶり66%、言葉70%の精度が出ました。さらに、研究者が話しかけて参加者が答える「会話」の形式でも試していて、2人目は身ぶり85%、言葉75%。1人目は3回分の試行で、身ぶりも言葉も中央値で100%だったと報告されています。ただし会話形式は試行回数がかなり少なく、「原理的にできる」ことを示す程度のもの、と論文自身が位置づけています。
おまけのようなデモとして、参加者のアバターと、研究者がキーボードで操作するもう一体のアバターが、仮想空間で会話するという実験も行われました。言葉は共通のチャット欄に文字として出て、身ぶりは各アバターが演じつつ、チャット欄には斜体の文字で記録される、という仕組みだったそうです。
2人という規模と、これからの課題
この研究は、装置の設計そのものに「会話は言葉だけでできていない」という考え方を組み込んだ点で新しいものです。ただ、規模はごく小さく、読み取れる語彙もまだ限られています。
まず参加者は、同時読み取りの部分で2人だけです。1人は脳卒中、1人はALSと、まひの原因も試し方も違っていて、その違いが結果にどう影響したのかは、この人数では判断できません。研究チーム自身が「もっと多くの、いろいろな背景の参加者で確かめる必要がある」と書いています。
語彙の小ささも、現時点では避けられない制約です。2人目の参加者では10の言い回しと10の身ぶりのすべての組み合わせ、つまり100通りを一つずつ試して学習データを集めました。これを実用的な語彙の規模でやろうとすると、組み合わせの数が爆発して、全部を集めるのは現実的ではなくなります。この点については、学習データにない組み合わせ(たとえば「こんにちは」と「うなずく」を一緒にやったデータがない状態)でも精度がほぼ落ちなかった、という追加の分析結果が示されていて、全部を集めなくても済む可能性があるとしています。とはいえ、これはあくまで小さな語彙での話で、大きな語彙で同じことが言えるかは今後の確認待ちです。
同時に試みたときの精度が、単独のときの精度にまだ届いていない点も、論文は正直に認めています。同時に2つのことをしようとすると認知的な負担が増えて脳活動のばらつきが大きくなることや、同時データの量がまだ足りないことが原因として挙げられていました。
それでも、一枚の電極シートと2本の学習モデルで、言葉と身ぶりを同時に、しかも本人のアバターの動きとして取り出せることが示されたのは確かです。オランダ・マーストリヒト大学の計算神経科学者クリスチャン・ヘルフ氏は、Natureの取材に対して、日常的に使われる神経補綴(脳と機械をつなぐ装置)への希望を感じさせる成果だと述べています。話せなくなった人が「言葉」だけでなく「うなずき」や「肩すくめ」を取り戻す。そういう方向に技術が向かい始めた、と受け取ってよさそうです。
関連する商品
この記事に関連する本や商品は、Amazon で探せます。
上のリンクから購入されると、このブログに紹介料が入ることがあります。
画像について
この記事の画像は AI(ChatGPT)で作った想像図で、ご自由にお使いいただけます。お使いになるときは、出典としてこの記事へのリンクを載せていただけるとうれしいです。
出典
原論文(英語・無料で全文が読めます):Brosler, S. C. et al., “Simultaneous speech and gesture decoding for multimodal communication in paralysis”, Nature Neuroscience(2026年9月14日)論文ページを開く
Natureのニュース記事(英語・冒頭は無料、続きは要ログイン):‘Multifunctional’ brain implant translates speech and gestures in real time(Nature, Miryam Naddaf, 2026年9月14日)
コメント