
この記事には広告(Amazon アソシエイトのリンク)を含みます。
日本語の音声合成AI「Irodori-TTS(イロドリ)」は、2026年の夏から秋にかけて立て続けに更新されました。6月まで最新だった v3 のあと、8月1日に v4-Small、8月11日に v4.1-Small、9月12日に高速版の v4.1-Small-MF、9月27日には約33億パラメータの v4-Large が出ています。いずれも開発者の Aratako(Chihiro Arata)さんが Hugging Face で公開しているものです。
v3 のころにインストールして使っている人は、何を入れ替えればよいのか。先に結論を書くと、ふだん使いのモデルは v4.1-Small に差し替えるのがいちばん無難です。モデル名を変えるだけで、v3 では別々だった2種類のモデルが1つにまとまり、お手本の声に長い音声を渡せるようになります。いちばん大きい v4-Large は声の作り分けでは一歩先を行きますが、漢字の読みの正確さでは v4.1-Small を下回り、ライセンスの条件も変わります。この記事では、v3 からの変更点を順にたどり、最後にコマンドの書き換え方をまとめます。
2本に分かれていたモデルが1本になった
v3 までの Irodori-TTS には、モデルが2種類ありました。お手本の音声から声をまねる「ベースモデル」(Irodori-TTS-500M-v3)と、「落ち着いた女性の声で」のように文章で声を指定する「VoiceDesign モデル」(Irodori-TTS-600M-v3-VoiceDesign)です。やりたいことに応じて、読み込むモデルを切り替える必要がありました。
v4-Small では、この2つが1つのモデルに統合されました。読み上げる文章、お手本の音声、声の説明文(キャプション)という3つの入力を、1つのモデルがまとめて受け取ります。お手本の声だけで生成することも、説明文だけで生成することも、お手本の声に「泣きそうな声で」という説明文を重ねることも、同じモデルで行えます。
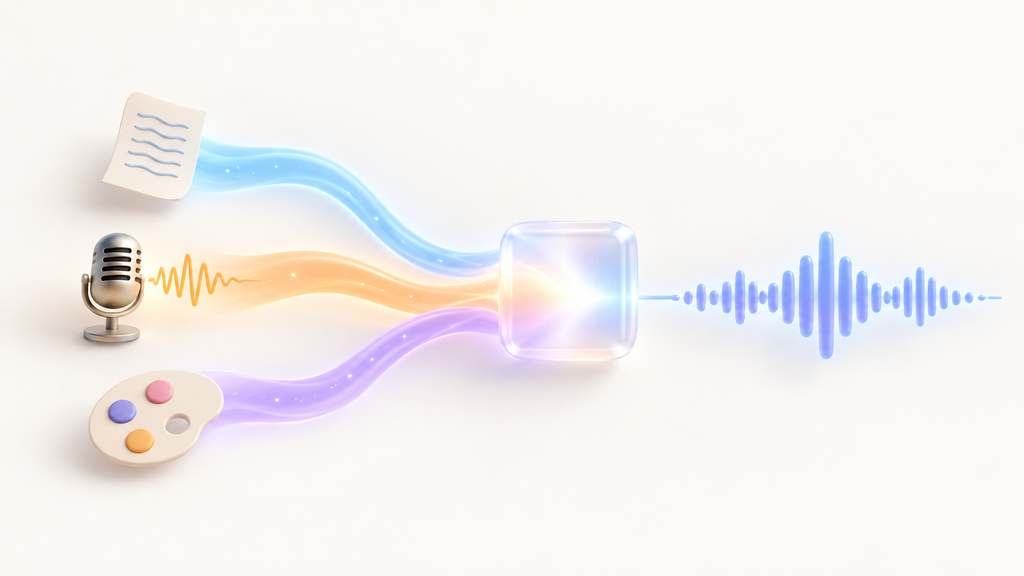
中身も変わっています。v3 までは、文章を読み取る部分(テキストエンコーダー)をゼロから学習していました。v4 では、SB Intuitions が公開している日本語の言語モデル ModernBERT-ja(3.1億パラメータ)を土台に学習し直したものを使います。日本語の文章をあらかじめ大量に読み込んだモデルを下敷きにしたことで、むずかしい漢字の読みと、説明文の理解がよくなったと開発者は説明しています。モデル全体の規模は約7.7億パラメータです。
もうひとつの変更が、お手本の音声の長さです。v3 までは30秒まででしたが、v4 では合計120秒まで渡せるようになりました。短いクリップを複数ファイル渡すと、モデルの側で順につなげて使います。開発者の評価では、お手本を1本の短いクリップから合計30秒前後に増やしたところで、声の似かた(話者類似度)がいちばん大きく伸び、そこから120秒まで増やしても伸びはわずかでした。長いお手本を用意できるなら、30秒ぶんを目標にすれば十分です。
v4.1 は「長さの見積もり」だけを直した
v4-Small の公開から10日後に出た v4.1-Small は、小さな修正版です。変わったのは、読み上げの長さを決める部分(Duration Predictor)だけで、声を作る本体はそのままです。
Irodori-TTS は、文章の長さや声の条件から「この音声は何秒になるか」を自分で見積もって生成します。v4-Small では、この見積もりを本体と一緒に学習していました。v4.1 では、本体の学習が終わったあとに本体を固定し、見積もりの部分だけをあらためて学習しています。開発者によると、これで音声の長さを過大に見積もって生成が崩れる失敗が減りました。
読みの正確さを測るベンチマーク(Joyo Kanji Yomi Benchmark)でも、文単位のかなの誤り率は v4-Small の2.89%から v4.1-Small の2.36%に下がり、v3-VoiceDesign の2.45%も下回りました。コードの変更は不要で、モデル名を v4.1-Small に変えるだけで切り替わります。Hugging Face の v4-Small のページにも「v4.1 を使うことを強くおすすめする」と書かれています。
4ステップで済む高速版「MF」
9月12日に出た v4.1-Small-MF は、v4.1-Small を先生役にして蒸留(大きなモデルの振るまいを少ない計算で再現するように学習すること)した高速版です。MF は MeanFlow の略で、画像生成の分野で提案された手法を音声に持ち込んでいます。
Irodori-TTS の本体は、雑音から音声へ少しずつ近づけていく方式(Rectified Flow)で音声を作ります。標準の設定では、この「少しずつ」を40回くり返します。回数を減らせば速くなりますが、v4.1-Small を4回で止めると読みも声の似かたも大きく崩れます。MF 版は、4回の各ステップで「区間ぜんたいの平均の進み方」を予測するように学習してあり、4回でも40回に近い結果が出ます。
開発者の評価では、お手本の音声を30秒前後渡したときの話者類似度(CAM++ のコサイン類似度)は、通常版の40ステップで0.7521、通常版を4ステップに減らすと0.3835まで落ちますが、MF 版の4ステップは0.7429でした。読みの誤り率も、4ステップどうしで比べると MF 版のほうがはっきり低く、40ステップの通常版には少し届かない、という位置です。
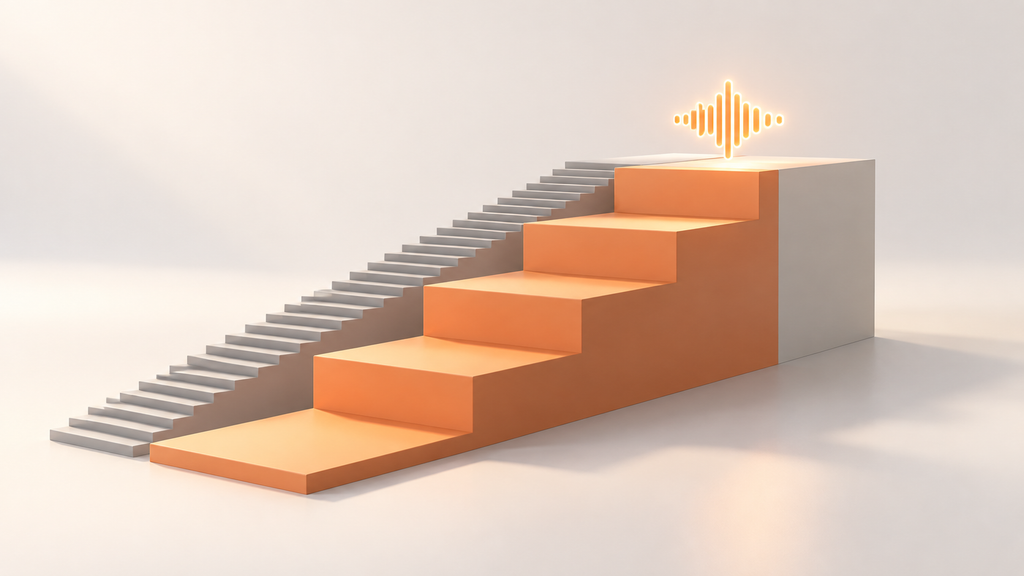
使い方は通常版と同じで、モデル名を Irodori-TTS-v4.1-Small-MF にするだけです。ステップ数を指定しなければ4ステップで動きます。ただし、生成時に条件の効きを調整する CFG の値や、Sway Sampling という高速化オプションは、MF 版では使えません。条件の効き具合は学習時に固定されています。
大きい v4-Large が出た。でも読みでは Small が上
9月27日に公開された v4-Large は、v4 の設計をそのまま大きくしたモデルです。パラメータ数は約7.7億から約32.9億へ、4倍あまりになりました。文章を読み取る部分も、ModernBERT-ja から Google の T5Gemma 2(google/t5gemma-2-1b-1b)のエンコーダーに置き換わっています。読み上げの長さの見積もりは、v4.1 と同じく本体とは別に学習したものです。
大きくなって何が伸びたか。開発者の評価では、声の説明文どおりの声が出るか(キャプションへの忠実さ)と、お手本の声への似かたが、どちらも v4-Small より上がっています。説明文の忠実さは、公開されている2,890件の声の説明文で音声を生成し、Gemini 3.6 Flash に5点満点で採点させたもので、平均は v4-Small の4.23点から v4-Large の4.30点に上がりました。長い文章を読ませたときの伸びがいちばん大きかったそうです。開発者自身が「人手の検証を入れていない簡易な内部比較」と断っている数字ですが、方向としては大きいほうが説明文をよく聞きます。
一方で、漢字の読みの正確さは、v4-Large が v4.1-Small を下回りました。常用漢字の読みベンチマーク(Parakeet 版)での正解率は v4.1-Small が93.42%、v4-Large が92.80%です。別のデータセット(JSUT)でも同じ傾向で、開発者もモデルカードの制限事項にこの点を書いています。「大きいほうを選べば全部よくなる」とはなっていません。
もう1点、ライセンスが変わります。v4.1-Small までのモデルは MIT ライセンスでしたが、v4-Large はエンコーダーに Google の T5Gemma 2 を使っているため、Gemma の利用規約(Gemma Terms of Use)と禁止用途ポリシーの適用を受けます。コードのほうは引き続き MIT です。商用利用などで条件を気にする場合は、v4-Large を選ぶ前に Gemma の規約を一度読んでおく必要があります。
サイズも大きく、モデルファイルは v4.1-Small が約2.9GB、v4-Large が約12.5GBです。v4-Large には重みを圧縮した量子化版(INT8・INT4・FP8)も同時に公開されていて、INT4 版でファイルは約2.8GBまで小さくなります。量子化版は NVIDIA の GPU で動作確認されており、実行時に bf16 精度の指定が必要です。
v3 の手順から何を変えるか
v3 のときの手順でインストールしてある場合、やることは3つです。コードを更新し、環境を同期し直し、コマンドのモデル名を変えます。
まず、Irodori-TTS のフォルダに入って、コードを最新にします。GitHub の main ブランチが v4 系のコードになっていて、v2・v3 のモデルも引き続き読み込めます(v1 のモデルだけは互換性がありません)。
cd Irodori-TTS
git pull
uv sync –extra cu128
最後の行は、v3 のときと同じく GPU の種類で変えます。AMD なら –extra rocm、Intel なら –extra xpu、GPU を使わないなら –extra cpu です。
次に、生成のコマンドです。公式の手順では、uv run のあとに –no-sync を付けるようになりました。これを付けないと、実行のたびに環境の同期が走って、選んだ GPU 向けの設定が外れることがあります。モデル名は Aratako/Irodori-TTS-v4.1-Small にします。お手本の声を使わず、文章だけから生成するなら次のとおりです。
uv run –no-sync python infer.py –hf-checkpoint Aratako/Irodori-TTS-v4.1-Small –text “こんにちは、私はAIです。これは音声合成のテストです。” –no-ref –output-wav outputs/sample.wav
声を文章で指定する場合、v3 のときは VoiceDesign 専用のモデルに切り替えて、–seconds で長さも指定していました。v4.1 では同じモデルのまま –caption を足すだけで、長さは自動で見積もられます。
uv run –no-sync python infer.py –hf-checkpoint Aratako/Irodori-TTS-v4.1-Small –text “こんにちは、私はAIです。これは音声合成のテストです。” –caption “落ち着いた、近い距離感の女性話者” –no-ref –output-wav outputs/sample_voice_design.wav
お手本の声をまねさせる場合は、–no-ref の代わりに –ref-wav でファイルを指定します。複数のクリップを渡すときは –ref-wavs にファイルを並べます。お手本に説明文を重ねることもできます。
uv run –no-sync python infer.py –hf-checkpoint Aratako/Irodori-TTS-v4.1-Small –text “複数の参照音声を使って合成します。” –caption “落ち着いた自然な声” –ref-wavs ref_01.wav ref_02.wav ref_03.wav –output-wav outputs/sample_long_reference.wav
手元の Web 画面(Gradio)も、v3 のときと同じ2つのコマンドで立ち上がります。どちらも標準で v4.1-Small を読み込むようになっているので、モデル名を打ち込む必要はありません。MF 版や v4-Large を試すときは、画面のチェックポイント欄にそのモデル名を入れます。インストールせずに触るなら、Hugging Face Spaces に v4.1-Small と v4-Large のデモが公開されています。
絵文字で表情をつける機能は v4 系でも使えます。対応する絵文字は45種類で、笑い(🤭)、ため息(😮💨)、早口(⏩)、電話越しの声(📞)、ナレーション調(📖)などがあります。どの絵文字がどう働くかは、モデルと一緒に配布されている EMOJI_ANNOTATIONS.md に一覧があります。効きかたは文脈によって変わり、必ず同じ結果になるわけではないと開発者も書いています。
乗り換えるときに知っておきたいこと
v4 系に移るときの注意を2つ書いておきます。
ひとつは、お手本の声が短いときの似かたです。開発者の評価では、短いクリップ1本だけをお手本にした場合、v4 系の話者類似度は v3 よりわずかに低くなりました。v4 系の長所は長いお手本を渡せることなので、お手本は30秒ぶんくらいを目安に、雑音の少ないクリップを複数用意すると、v3 より似た声になります。1本の長い録音を渡すこともできますが、学習と評価は短いクリップをつなげたもので行われていて、長い1本の録音での効果は確かめられていません。
もうひとつは、お手本の声と説明文が食い違う場合です。お手本は男性の声なのに説明文で「若い女性」と書くと、音が不安定になったり、どちらかの指示が無視されたりします。声の正体はお手本に任せ、説明文は感情や話し方、場面の指定に使うのが、開発者のすすめる使い分けです。
利用上のルールは v3 のときと変わりません。本人の同意なく実在の人物の声を複製しないこと、人をだます目的の音声を作らないことが、ライセンスとは別の倫理的制限として示されています。生成した音声には、対応する環境であれば SilentCipher による電子透かしが自動で入ります。v4-Large については、前に書いたとおり Gemma の規約もあわせて確認してください。
v3 を使っていて特に困っていないなら、急いで変える必要はありません。ただ、モデル名を1か所書き換えるだけで、モデルの切り替えが要らなくなり、長いお手本も渡せるようになります。手元の環境を更新するついでに試してみる価値はあります。
出典・リンク
- Irodori-TTS(GitHub/インストール・実行手順)
- Irodori-TTS-v4.1-Small(モデルカード/Hugging Face)
- Irodori-TTS-v4-Small(v4 の変更点と評価/Hugging Face)
- Irodori-TTS-v4.1-Small-MF(MeanFlow 高速版のモデルカード/Hugging Face)
- Irodori-TTS-v4-Large(モデルカード/Hugging Face)
- Irodori-TTS-v4-Large-Quantized(量子化版/Hugging Face)
- EMOJI_ANNOTATIONS.md(対応する絵文字の一覧)
- Irodori-TTS-v4.1-Small Demo(ブラウザで試せるデモ/Hugging Face Spaces)
- Parameter Guide(各種パラメータの詳細/GitHub)
関連する商品
この記事に関連する本や商品は、Amazon で探せます。
上のリンクから購入されると、このブログに紹介料が入ることがあります。
コメント