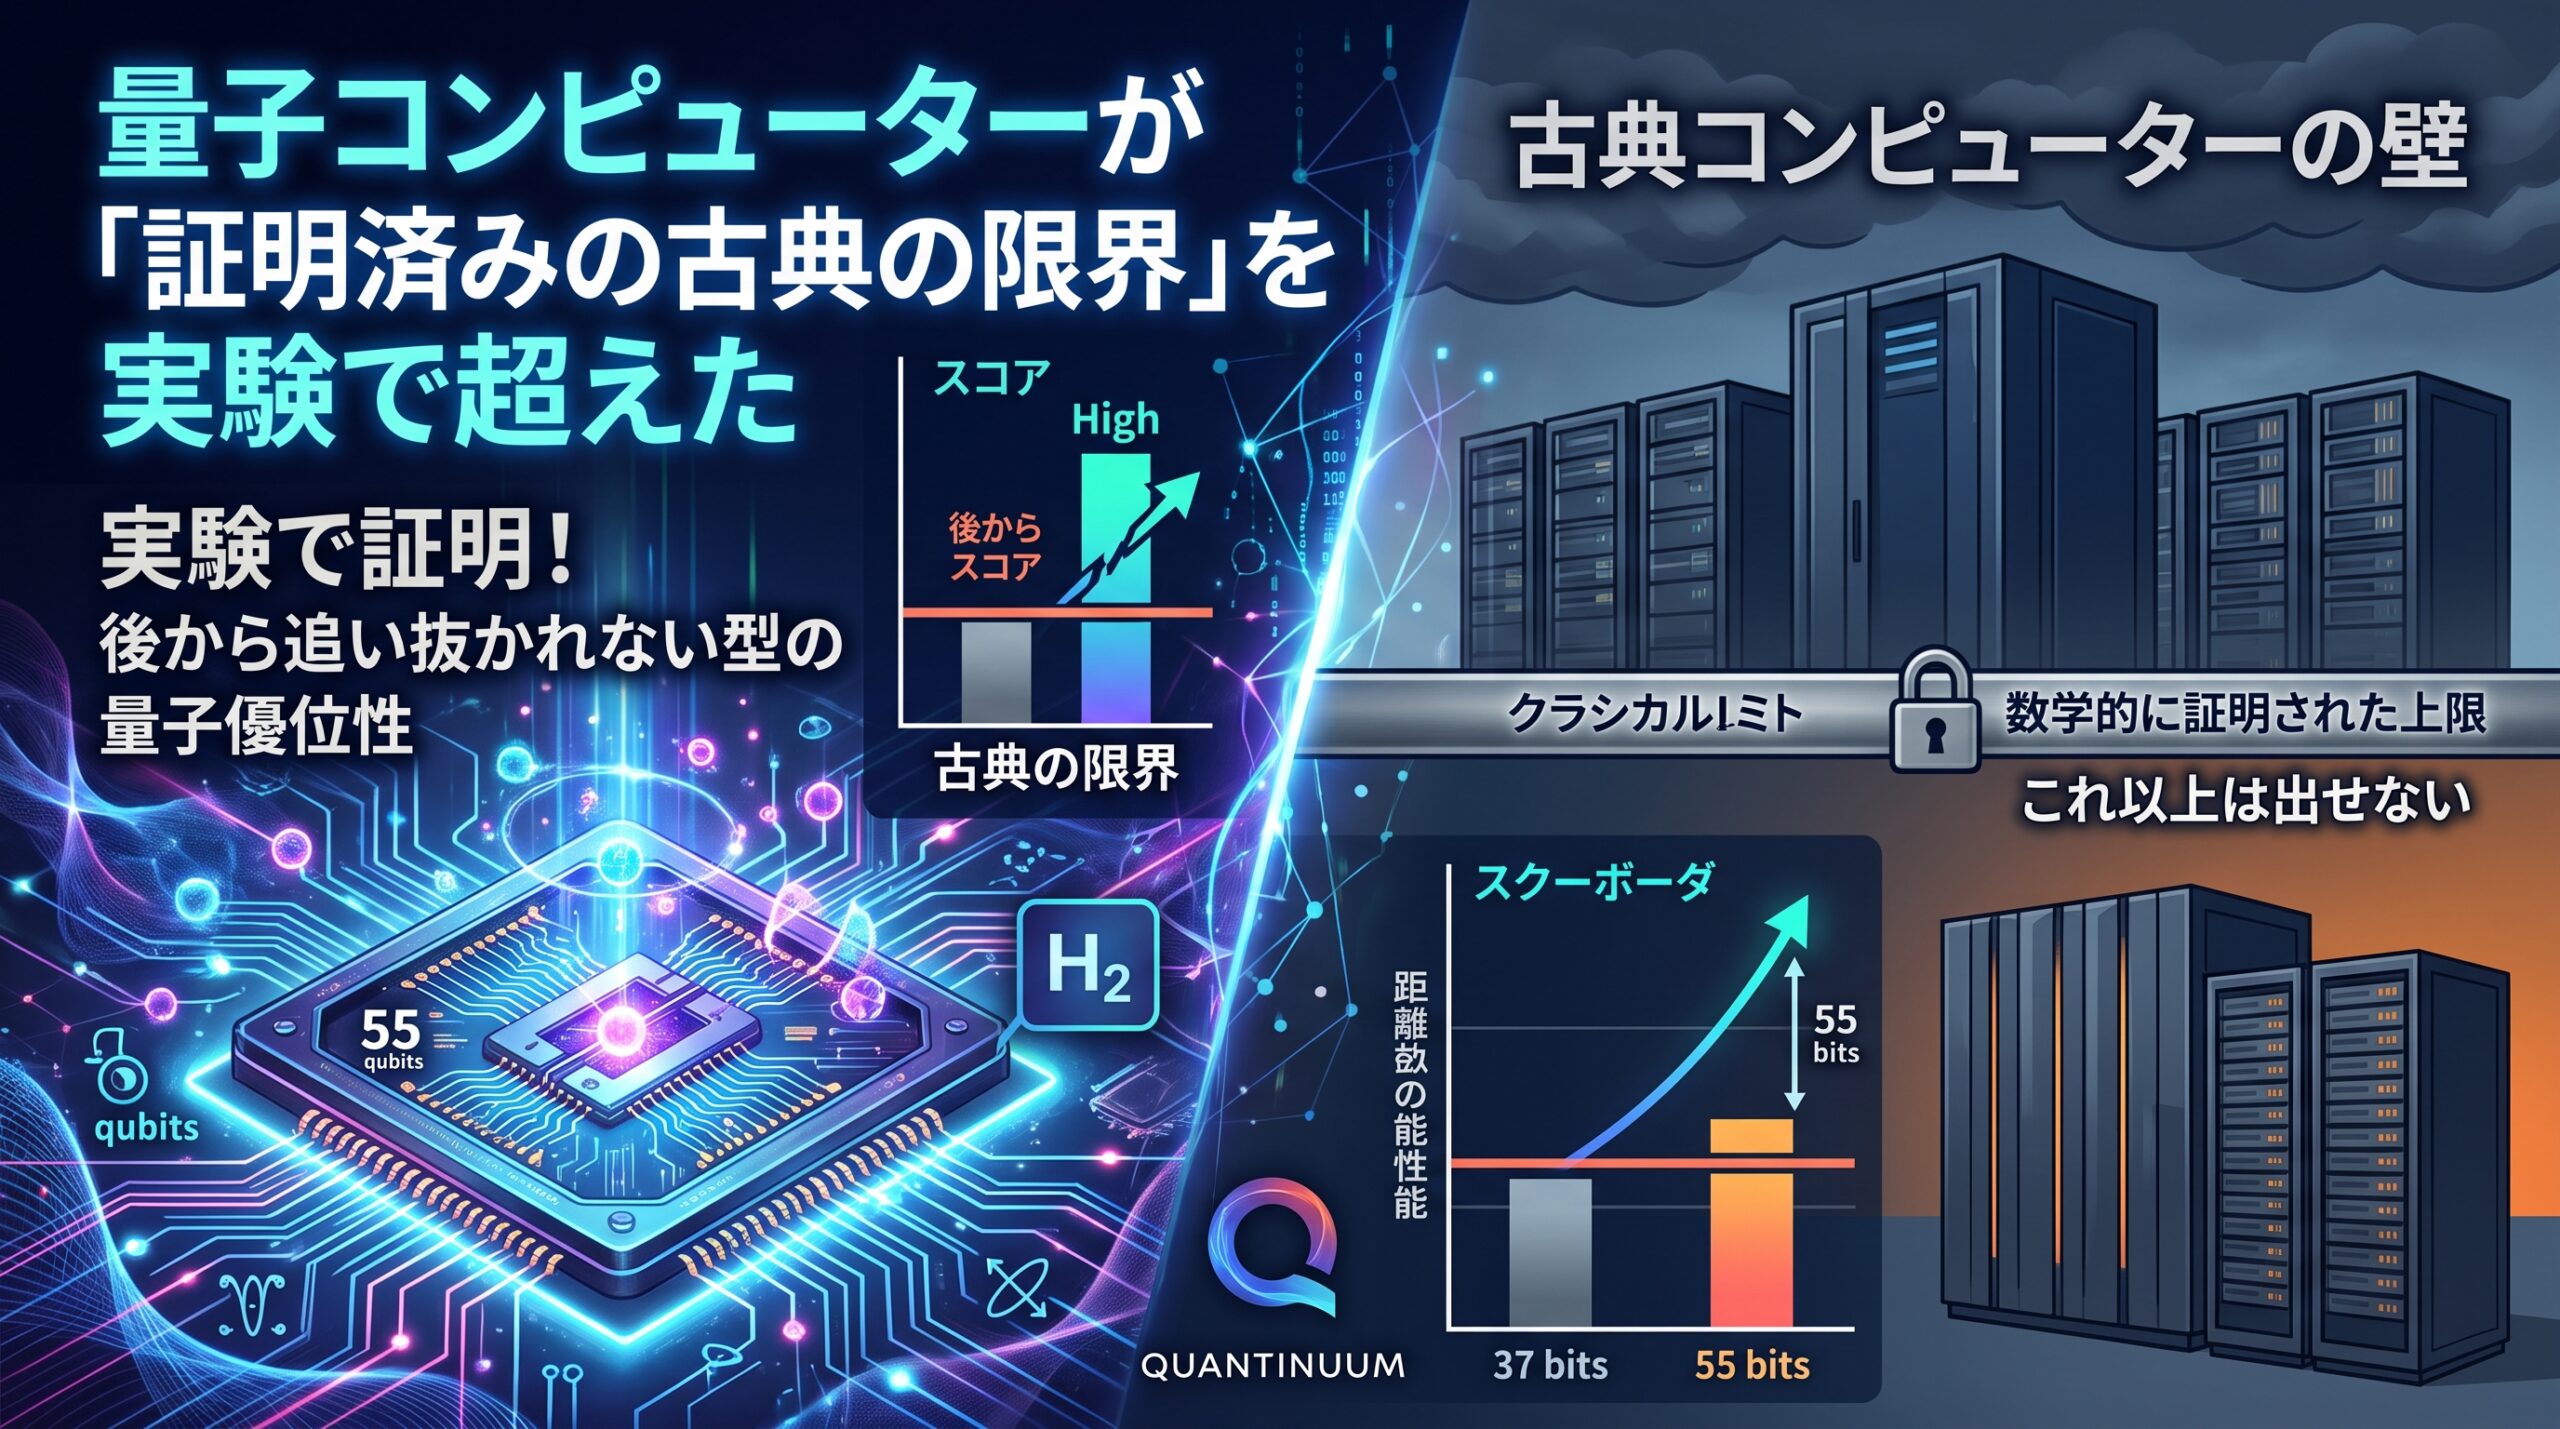
量子コンピューターが、「古典コンピューターではここまでしか出せない」と数学的に証明されている点数を、実験で上回った——という話です。
報告したのは、イギリスの量子コンピューター企業Quantinuum(クオンティニュアム)のMarcello Benedetti氏、Harry Buhrman氏らのチーム。論文は2026年9月5日付でNature Communications誌に掲載されました(査読済み、無料で読めるオープンアクセス)。使ったのは同社のイオントラップ型量子コンピューター「H2」で、最大55量子ビットを使い、数千種類の回路を走らせています。
「量子コンピューターが古典を超えた」という発表は、ここ数年で何度も出ています。それでもこの結果が一本の記事に値するのは、これまでの「超えた」とは中身が違うからです。どこが違うのかを、順を追って見ていきます。
これまでの「量子優位性」に付きまとう弱点
量子コンピューターの実力を示す実験は、2019年にGoogleが「量子超越性」を宣言して以来、いくつも報告されてきました。ただ、その多くには共通の弱点があります。
一つは、「古典では無理」という主張が仮定の上に立っていることです。「この計算は古典コンピューターだと何万年もかかる」と言うとき、その根拠は「効率のよい古典アルゴリズムは存在しないだろう」という、証明されていない見立てです。実際、Googleの2019年の実験については、その後に古典側のシミュレーション手法が改良され、当初の見積もりよりはるかに短い時間で再現できると主張する研究が相次ぎました。「超えた」はずの線が、あとから動いてしまったわけです。
もう一つは、答え合わせの難しさです。量子コンピューターが出した結果が本当に正しいかを確かめようとすると、その確認作業自体に古典コンピューターでは手に負えない計算が必要になることがあります。規模を大きくすればするほど、「正しいかどうか誰にも確かめられない」状態に近づいていきます。
つまり、「古典側の限界がはっきり決まっていて」「答え合わせが簡単で」「規模を大きくしても成り立つ」——この三つがそろった試験が、なかなかなかった。今回の実験は、この三つを一度にそろえることを狙ったものです。
補集合サンプリングというゲーム
チームが使ったのは、「補集合サンプリング(complement sampling)」という課題をもとにしたゲームです。ルールはこうです。
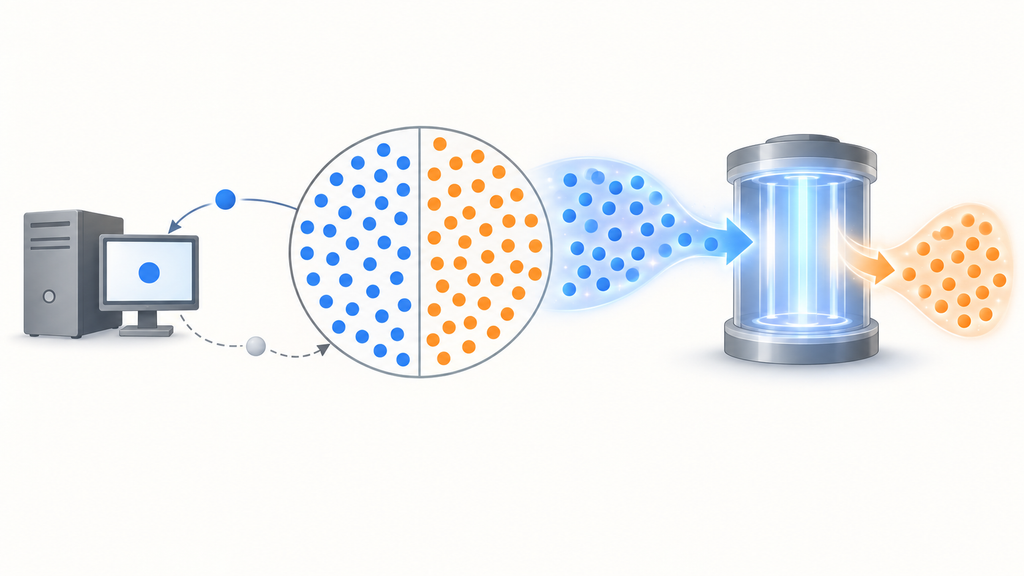
まず、ありうる答えの全体を、審判がこっそり半分ずつ二つのグループAとBに分けます。挑戦者には、Aの中からランダムに選んだ一つだけが渡されます。挑戦者の仕事は、Bに属する答えを一つ返すこと。それだけです。
答え合わせは簡単で、審判は返ってきた答えがBに入っているかを見るだけで済みます。ここが、確認の手間で行き詰まる従来の試験との大きな違いです。
では、古典コンピューターはこのゲームでどこまでやれるでしょうか。渡された一つの答えがAに属することは分かるので、それを返さなければよい。しかしそれ以外の答えについては、AなのかBなのか、手がかりがまったくありません。残りの中から適当に選ぶしかなく、当たる確率は半分程度にとどまります。しかも答えの候補が増えるほど、渡された一つの情報は相対的にどんどん薄くなります。
重要なのは、この「古典ならここまで」が、見立てではなく数学的な証明として出ている点です。どれだけ賢いアルゴリズムを持ち出しても、古典的な方法である限り、この上限より上には行けません。
あとから追い抜かれない型の優位性
ここが今回の話の核心です。量子コンピューターは、このゲームを「渡された一つの答え」から始めていません。
量子ビットは、観測するまで0と1の両方を同時にとる「重ね合わせ」の状態でいられます。この性質を使うと、審判は挑戦者に、Aの要素を一つ選んで渡すのではなく、Aの要素すべてを重ね合わせた一つの量子状態として渡せます。
そして量子コンピューターは、その状態を観測する前に、いじることができます。チームが「スワッパー」と呼ぶ回路を通すと、「Aの全部を重ね合わせた状態」が「Bの全部を重ね合わせた状態」に入れ替わります。そのあとで観測すれば、出てくるのは必ずBの要素です。ノイズのない理想の量子コンピューターなら、このゲームには毎回勝てます。
一方の古典コンピューターは、渡された量子状態を観測して一つの答えに潰すところから始めるしかないので、結局「Aから一つもらう」以上の情報を引き出せません。
つまり、量子側は理想なら常に勝ち、古典側は証明された上限に頭を押さえられる。しかもその上限は、問題のビット数が増えるにつれて、指数関数的に、つまり桁ごとに下がっていきます。差は開く一方で、古典側が「新しいアルゴリズムを思いついたので追いつきました」と言える余地が、そもそも残されていない。「後から抜き返される」ことが原理的に起こらない型の量子優位性——それがこの研究の一番の売りです。
実験では、答えを表す文字列の長さを最大37ビットまで伸ばして、この差を実際に測っています。結果は、すべての規模で古典の上限を上回り、その差は問題が大きくなるほど指数関数的に広がりました。理想の量子戦略が出すはずの点数にはわずかに届いていないものの、傾きはほぼそれに沿っていて、古典的な戦略では統計的に説明がつかない水準だったといいます。
実機ならではの制約
もちろん、実際の装置は理論どおりにはいきません。問題を大きくすると必要な量子操作が増え、そのぶん装置の雑音で点数は落ちていきます。今回の実験でも、規模が最大になるにつれて理想からのずれは大きくなっています。それでも古典の上限は割っていない、というのが結果の読み方です。
もう一つ、研究チーム自身が挙げている限界があります。このゲームは本来、答えを出す「審判」と、答えを返す「挑戦者」が別々の存在であるはずのものです。しかし今回は、両方を同じ量子コンピューターの上に置き、二者間のやりとりを量子テレポーテーションで模擬しています。厳密にやるなら、審判と挑戦者を別々の量子コンピューターに分け、本物の量子通信路でつなぐべきで、それは次の段階の実験に持ち越されています。
この結果の意味と、意味しないこと
この結果が示しているのは、「量子コンピューターが古典より速く役に立つ計算をした」ということではありません。補集合サンプリングは、実用的な計算問題というより、量子コンピューターが本当に量子的に動いているかを効率よく確かめるための試験問題です。研究チームも、これを量子ハードウェアの新しい検証手段として位置づけています。
ただ、その試験問題として見たとき、今回の設計はかなり筋がよいものです。古典の限界が証明で固定されていて、答え合わせが簡単で、規模を大きくしても同じ枠組みで測れる。装置が改良されて雑音が減れば、同じゲームを使ってそのまま「理想にどこまで近づいたか」を追いかけられます。
また、論文のまとめによれば、この試験は量子のもつれや非局所性——量子力学の不思議さの代名詞としてよく挙がる性質——には依存せず、重ね合わせの力だけを見ている点も特徴です。何が量子コンピューターの力の源なのかを切り分けて確かめる手段として、今後ほかの装置にも使われていくかもしれません。
審判と挑戦者を本当に分離した実験が成功するかどうかは、まだこれからです。
出典
Benedetti, M., Marin-Sanchez, G., Weggemans, J., Rosenkranz, M. & Buhrman, H. “Unconditional and exponentially large violation of classicality.” Nature Communications (2026). https://doi.org/10.1038/s41467-026-77413-3(オープンアクセス)
ScienceAlert: Quantum Computers Just Passed a Test That Classical Computers Fundamentally Can’t
Quantinuum 技術ブログ(補集合サンプリングの理論解説): Unlocking Quantum Advantage with Complement Sampling
コメント