この記事には広告(Amazon アソシエイトのリンク)を含みます。
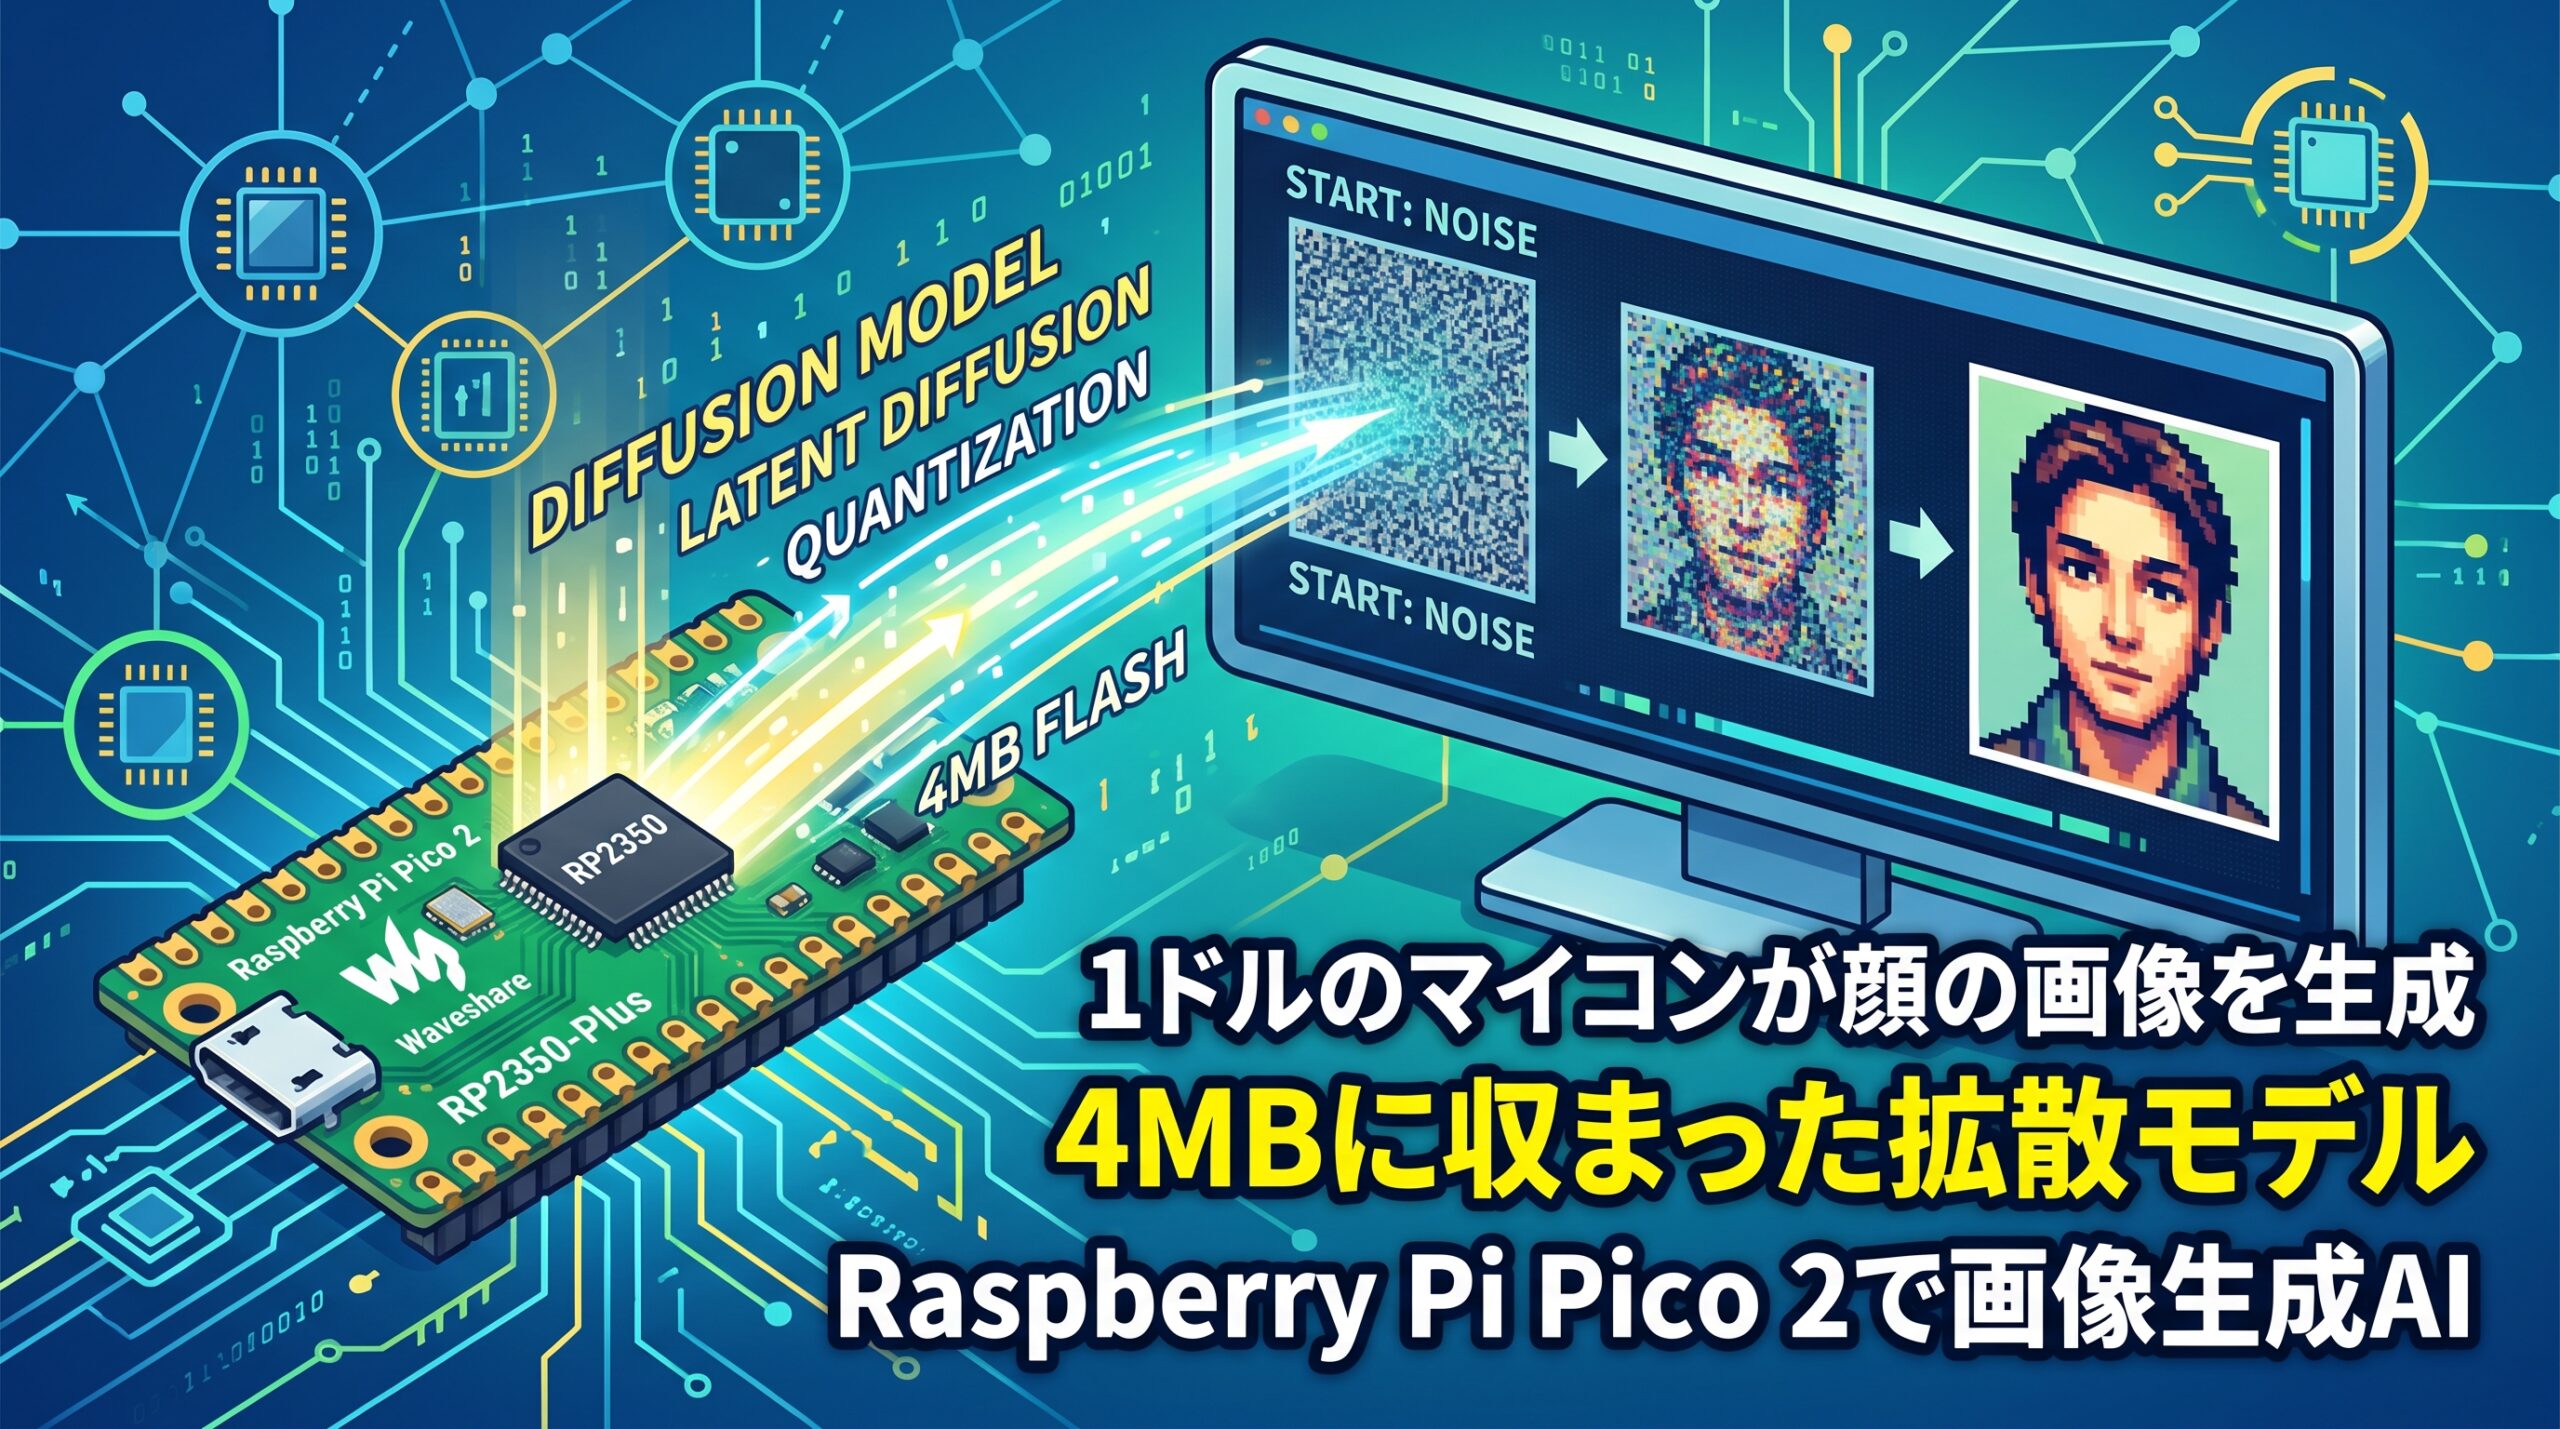
画像生成AIといえば、データセンターのGPUを何枚も並べて動かすもの、というのが今の常識だろう。その常識に真正面から逆らう工作が公開された。Raspberry Pi Pico 2に載っているマイコン「RP2350」1個で、人の顔の画像を一から生成するというものだ。作者はcpldcpuの名前で知られるTim氏。2026年8月28日に自身のブログで詳細を公開し、9月5日にHackadayが取り上げた。
ハードウェアはWaveshare製のRP2350-Plusという開発ボード1枚に、VGA出力用の小さなアダプタを挿しただけ。チップ単価は約1ドル、メモリはRAMが520KB、プログラムを置くフラッシュが4MBという、AIどころか高解像度の写真1枚すら丸ごと読み込めない規模の機械である。ここで128×128ピクセルのカラーの顔画像を、1枚あたり10〜20秒ほどで作り出し、VGAモニターに映すかUSB経由でパソコンに送る。「男性・女性」「笑顔あり・なし」の指定も効く。
コードとモデルはGitHubで公開されていて、同じボードがあれば誰でも試せる状態になっている。
拡散モデルが大がかりな計算機を求めてきた理由
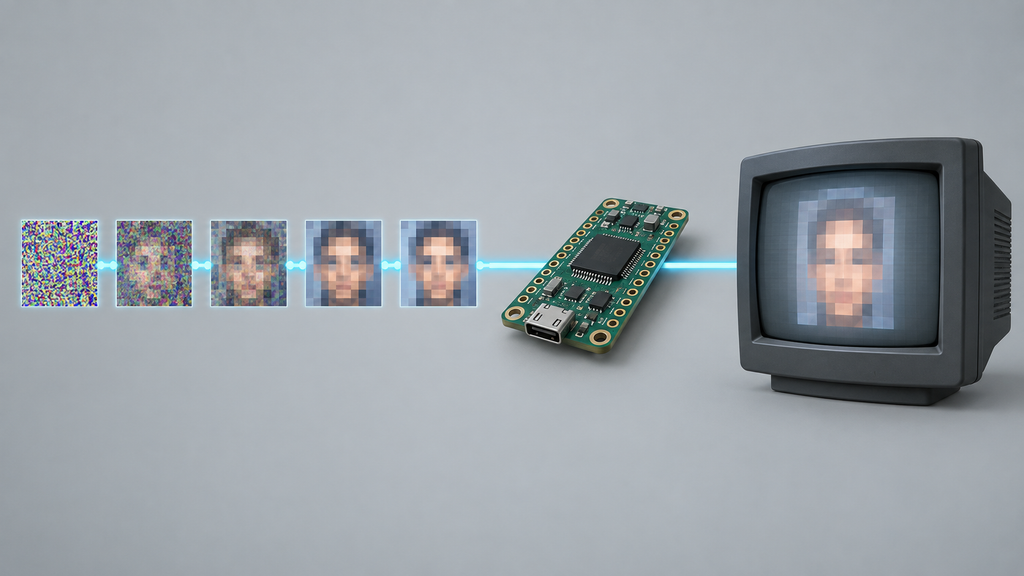
今回動いているのは拡散モデル(ディフュージョンモデル)と呼ばれるタイプの画像生成AIで、Stable DiffusionやFluxなど、いま主流の画像生成サービスの多くが同じ仲間に入る。仕組みをひとことで言えば、砂嵐のようなノイズ画像から始めて、「もう少し顔らしく」という方向に少しずつ書き換えていく作業を何回も繰り返し、最後にきれいな画像を得るというものだ。
この方式は画質が高い代わりに、計算量が桁違いに多い。1枚作るのに同じネットワークを何十回も通す必要があり、しかもそのネットワーク自体が巨大だ。たとえばFluxのパラメータ数(学習で決まる数値の個数)は120億個規模で、数値をそのまま保存するだけで数十GBになる。一般的なパソコンのグラフィックボードでも動かすのに苦労する量で、だからこそ画像生成はクラウド側でやるのが当たり前になっている。
マイコンでAIを動かす試みはこれまでもあった。ただ、多くは手書き数字の認識のように、入力を「これは何か」と判定する方向のものだった。ノイズから画像を生み出す拡散モデルを、しかも人の顔という複雑な対象で、フラッシュ4MB・RAM520KBの機械に載せた例は珍しい。Tim氏自身も、手書き数字を生成する程度の実験モデルですら今回より多いパラメータを使ってまともな絵が出ないことが多いのに、この規模で顔が出ること自体が驚きだと書いている。
4MBに詰め込むための3つの工夫
まず、ピクセルを直接いじらない。128×128×3色の画像を、いったん16×16×8という圧縮された「潜在表現」に置き換えて、その小さな空間の中でノイズ除去を進める。データ量にして24分の1だ。最後に「デコーダ」と呼ばれる小さな復号器で、圧縮表現から画像に戻す。これは潜在拡散という手法で、Stable Diffusionが広めた考え方でもある。
面白いのは、この復号器の作り方だ。圧縮する側(エンコーダ)はわざと大きく作ってパソコンで動かし、戻す側(デコーダ)だけを極端に小さく作ってマイコンに載せる。大きなエンコーダに「小さなデコーダでも元に戻せるような圧縮のしかた」を学ばせる、という発想である。マイコン側に要るのは戻す方だけなので、エンコーダの大きさは関係ない。
次に、数値の精度を落とす。学習は通常の浮動小数点で行い、できあがった重みを8ビット整数に丸めて保存する(量子化)。これでモデルの容量は4分の1程度になる。ただしここは苦労した部分で、とくに大きい方のモデルは丸めによる画質の劣化が目立ち、量子化したあとに再学習で補正する手当てが必要だったという。
最後に、途中計算の結果を表に置き換える。拡散モデルでは「今は何ステップ目か」「どのクラス(笑顔の男性など)を作るか」という条件を、ネットワークの各層に小さな補助ネットワークで注ぎ込むのが普通だ。ところが今回のモデルではステップ数が8、クラスが5しかない。組み合わせは40通りしかないので、補助ネットワークをまるごと捨てて、40通りの答えをあらかじめ計算した表を置いておけば済む。これで計算も容量も減る。
結果として、速い方のモデルは約2.5MB、画質重視の大きい方でも約4MBで、推論プログラム込みでフラッシュに収まった。パラメータ数は170万個と290万個。Fluxのおよそ4000分の1である。
巨大モデルと同じ部品を、そのまま縮めた設計
ここまで読むと「小さい機械向けに、何か特別な軽量手法を編み出したのだろう」と思えるが、実際はほぼ逆だった。Tim氏が自分でも意外だったと書いているのは、巨大モデルを賢くするために発明されてきた工夫の大半が、この極小モデルを動かすためにも必要だった、という点である。
たとえばネットワークの骨格。小さな機械には昔ながらの畳み込み型(U-Net)のほうが向くと踏んで最初はそちらを試したが、結局トランスフォーマー型のほうがすっきりして性能も良かった。これはFluxやSora系のモデルが採用している「拡散トランスフォーマー(DiT)」と同じ構造だ。条件を注ぎ込む方式もDiTの論文で提案されたAdaLN-Zeroをそのまま使っている。
効果が大きかったのが、分類器なしガイダンス(CFG)と呼ばれるテクニックだ。「笑顔の女性」と指定して計算した結果と、何も指定せずに計算した結果を両方出し、その差を強調する。指定した方向だけを取り出して増幅するようなもので、計算時間は2倍になるが、出てくる顔のはっきりさが目に見えて変わる。これも本来は大規模モデルの画質を引き上げるために考え出された手法で、Stable Diffusion以降の多くのサービスの裏で動いている。
つまり、1ドルのマイコンで動いているのは「マイコン用の簡易版AI」ではない。潜在拡散、拡散トランスフォーマー、AdaLN、CFG、フローマッチングによる学習と、クラウドで動く最先端モデルと同じ部品を並べ、パラメータの数だけを4000分の1に削った縮尺模型だ。大きくしないと効かないと思われていた工夫が、この規模まで縮めても同じように効いた、というのが今回いちばん考えさせられる発見だと思う。
推論プログラムの側の工夫
モデルが4MBに収まっても、RAMが520KBしかない以上、重みをまとめて読み込むことはできない。そこで、各層の重みをフラッシュからDMA(プロセッサを介さない自動転送)で少しずつ流し込みながら、前の層の計算を並行して進める。トランスフォーマーはひとつの層の重みを64個のトークンで使い回すため、読み込み速度がボトルネックになりにくいという性質がここで活きている。
Cortex-M33の2つのコアを両方使い、クロックは定格の150MHzから300MHzまで引き上げている。掛け算を2つ同時にこなす命令を使うなど地道な最適化を重ね、最初の実装から15倍ほど速くなって1枚約5秒に到達した。その後、大きいモデルとCFGを入れて約20秒に戻ったが、それでも拡散モデルとしては十分速い。生成中はVGAモニターに圧縮表現のプレビューがぼんやり映り、完成すると顔に置き換わる。画面用のメモリは生成中は計算の作業領域として使い回されている。
開発にはClaude Codeによるコーディング支援を使ったと本人が明かしているが、それでも学習の試行錯誤には2週間ほどかかり、夜間はRTX 5090で学習を回し続けたという。学習に使ったのは、顔画像7万枚を集めた公開データセットFFHQである。
限界と、この先の余地
できることははっきり限られている。解像度は128×128で、作れるのは人の顔だけ。指定できるのも性別と笑顔の有無の4通りに「指定なし」を足した5種類で、テキストで好きなものを注文できるわけではない。画質も、Hackadayの評では「自然とは言いがたいが、顔だと十分にわかる」程度で、歯のような細部は圧縮表現の情報量が足りていない。Tim氏自身、量子化に強い学習方法や、条件の表をさらに小さくする手法など、まだ手をつけていない改善点がいくつもあると書いている。
それでも、数百円で買えるマイコンの中に、クラウドで動いている画像生成AIと同じ設計図が丸ごと入ったという事実は残る。用途がすぐに思いつくかは別として、「AIはネットにつながった大きな機械がやるもの」という前提は、少なくとも技術的にはもう絶対ではない。この設計がどこまで縮み、どこまでのことができるのかは、まだ誰も試し切っていない。
関連する商品
この記事に関連する本や商品は、Amazon で探せます。
上のリンクから購入されると、このブログに紹介料が入ることがあります。
出典
Tim氏のブログ(2026年8月28日):AI Image Generation on an RP2350 Microcontroller
GitHubリポジトリ:cpldcpu/pico-faces
Hackaday(2026年9月5日、Aaron Beckendorf):Running Generative AI On An RP2350
コメント