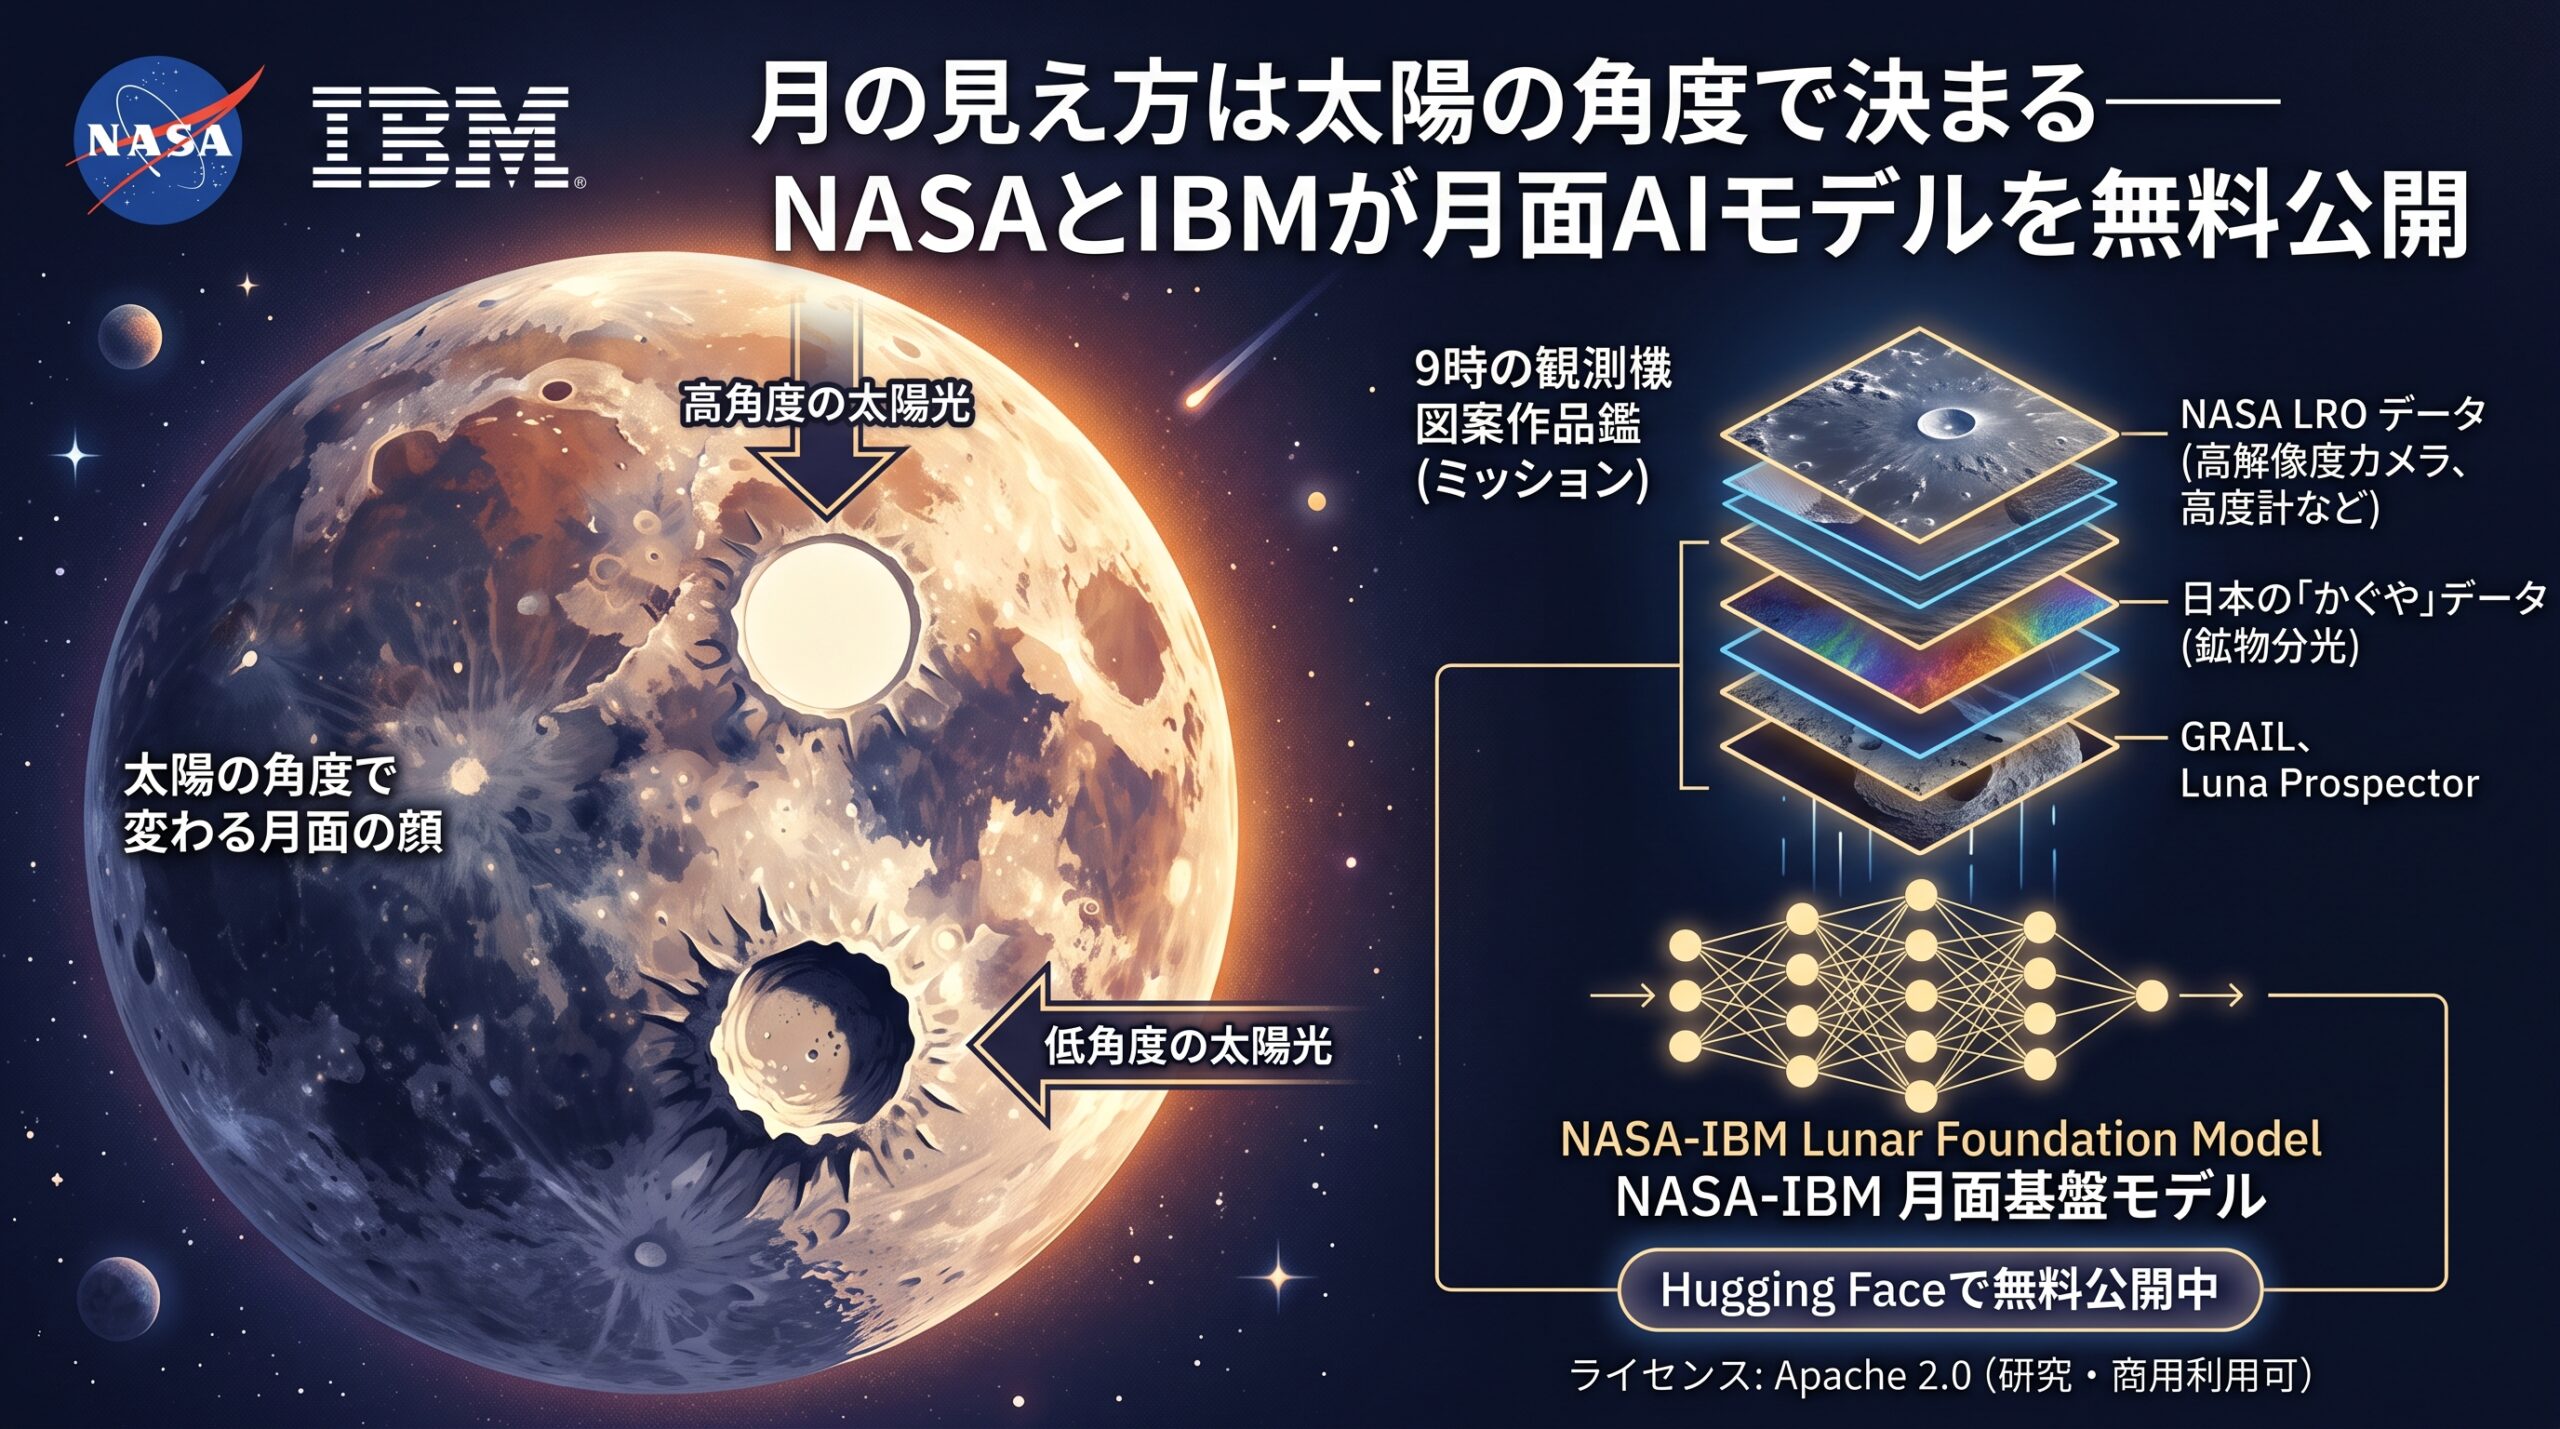
NASAとIBMが、月面の観測データを一つにまとめて学習させたAIモデル「NASA-IBM Lunar Foundation Model」を、2026年9月10日に公開しました。学習済みの重み(モデルの中身そのもの)は、AIモデルの共有サイトHugging Faceで誰でも無料でダウンロードできます。ライセンスはApache 2.0なので、研究にも商用にも使えます。
この2社は2023年に地球観測衛星の画像を扱うモデル「Prithvi」を公開し、その後は気候・天気のモデル、去年は太陽フレアを予測する「Surya」を出してきました。今回の月モデルもその系列に入るもので、対象を地球から月へ、そして太陽へと広げてきた流れの最新版という位置づけです。
学習に使われた月のデータ
月の観測データと一口に言っても、中身はばらばらです。今回のモデルに入っているのは、大きく分けて4つの探査機から集めた、9つの観測機器のデータです。
中心になっているのは、2009年から今も月を回り続けているNASAの周回機LRO(ルナー・リコネサンス・オービター)です。地表を1ピクセル約1メートルで写す高解像度の狭角カメラ、1ピクセル約100メートルで広く写す広角カメラ、レーザーで高さを測る高度計、地表の温度を測る放射計、地下の様子を探るレーダーと、LROだけで5つの機器が使われています。
そこに、月の重力分布を測ったGRAIL、1990年代末に月の北極と南極で水素を検出したルナ・プロスペクターのデータが加わります。そしてもう一つが、日本の「かぐや」です。かぐやが2007年から2009年にかけて集めた鉱物の分光データ(光の波長ごとの反射から、地表がどんな岩石でできているかを調べたもの)が、地表の組成を示す層として組み込まれています。日本の探査機の成果が、こういう形で世界の基盤データに残っていくのは、素直にうれしいところです。
これらを位置合わせして、同じ場所の同じ範囲を切り出したタイルの束にしたものが、SomBenchというデータセットです。タイルの数は広角側が約96万、狭角側が約100万で、合わせておよそ200万。データセット自体も同じくHugging Faceで公開されています。
基盤モデルという作り方
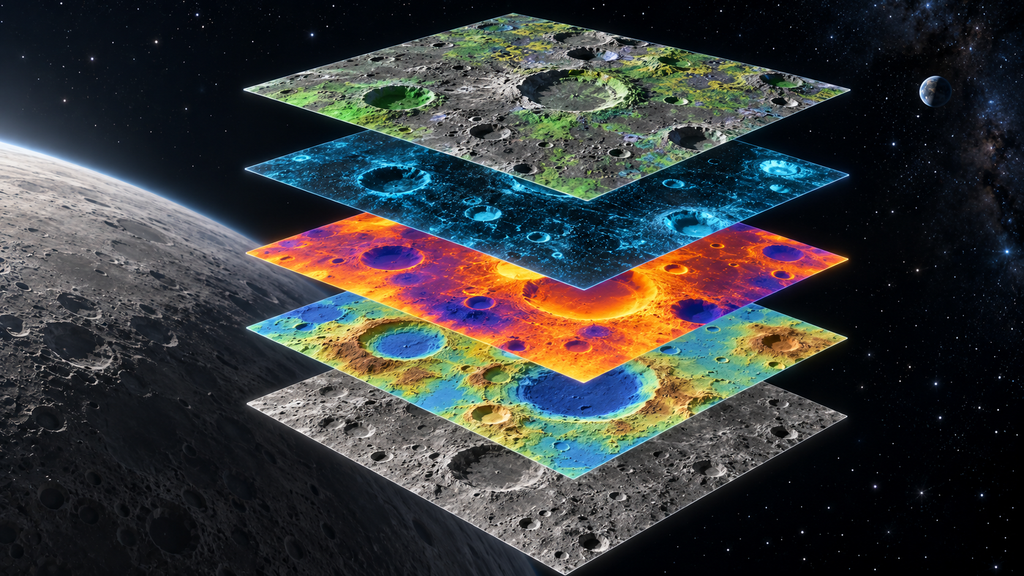
上の図のように、同じ場所について何層ものデータが積み重なっています。これまで月の研究者は、この層を一つずつ手で見比べるか、目的ごとに小さな機械学習モデルを作るしかありませんでした。クレーターを数えるならクレーター検出専用のモデル、氷を探すなら氷探索専用のモデル、という具合です。
今回のモデルは、そのやり方を変えるためのものです。「基盤モデル」というのは、特定の仕事を教え込む前の、いわば下地の段階のモデルのことです。大量のデータを見せて、月面の写真・地形・温度・組成がどう対応しているかを先に覚えさせておく。あとは使う側が、クレーター検出なり氷の探索なり、自分の目的に合わせて少しだけ追加学習をさせれば、そのまま道具として使える。文章を扱う大規模言語モデルで当たり前になったやり方を、月面データに持ち込んだわけです。
ここで一つ、月ならではの工夫があります。
月の見え方を決める太陽の角度
地球の衛星画像を扱うAIと、月面のAIで何が違うのか。技術レポートの言い方を借りると、月面の見え方は、地表そのものの違いよりも、太陽の光がどの角度から当たっているかで決まる、ということです。
月には大気がないので、光を散らすものがありません。同じクレーターでも、太陽が真上にあればのっぺりした円に見え、低い角度から差せば深い影を落として全く別の顔になります。写真だけ見せて「これがクレーターだ」と覚えさせようとすると、AIはクレーターの形を覚える前に、影の付き方に振り回されてしまう。
そこで開発チームは、太陽の入射角や観測角度、そのタイルの位置といった撮影条件を、画像とは別の入力として最初からモデルに渡すことにしました。「この写真はこういう光の当たり方で撮った」と先に教えてから、中身を見させる。撮影条件は観測データに必ず記録されているものなので、AIに推測させる意味がない。だったら渡してしまえ、という発想です。
もう一つの工夫が、解像度の違いを一つのモデルで扱っている点です。狭角カメラの1メートルと広角カメラの100メートルでは、縮尺が100倍違います。ふつうは別々のモデルを作るところを、両方のタイルを混ぜて一緒に学習させ、一組の重みで両方の縮尺をカバーさせました。細かく見たいときと広く見たいときで、モデルを持ち替えなくて済みます。
効果は数字にも出ています。広角画像でのクレーター検出では、学習用の正解データを半分に減らしても、既存の画像認識モデルに全量の正解データを与えた場合と同じか、それ以上の精度が出ました。極域の氷が存在しそうな場所を推定するタスクでは、既存モデルとの差が最も大きく開いています。正解データを作るのに人手がかかる分野なので、少ないデータで済むというのは実務上かなり効きます。
できることと、できないこと
ここまで読むと万能に見えますが、公開されたモデルカード(モデルの説明書)には、できないことがはっきり書いてあります。この正直さが、今回の公開でいちばん信頼できる部分だと思っています。
まず、このモデルは月の地図を描くものではありません。あくまで「月面データを読み取るための下地」であり、絶対的な座標を持っていません。地形の形は再現できても標高の基準がずれる、生成した緯度経度が数十度ずれることもある、と明記されています。着陸地点の最終判断や、危険箇所の確認といった運用上の決定には使えない、とも書いてあります。
氷についても注意が要ります。「永久影の氷を探す」と報じられていますが、モデルが学習した正解は、既存の観測データを専門家のルールで重ね合わせた「氷がありそうな度合い」の地図であって、実際に測った氷の量ではありません。モデルが出すのは、その地図の再現です。氷そのものを見つけたわけではない、という点は覚えておいたほうがいいでしょう。
また、モデルの規模はViT-Bという、画像認識では中くらいの大きさです。学習にかかった計算量はNVIDIA H100を16枚使って約1,100GPU時間で、大規模言語モデルの学習と比べればずっと小さい。IBMの担当者はThe Registerに対し、追加学習の実験は主にA100で行ったと答えています。研究室レベルの設備で追加学習ができる大きさに収めてある、ということです。
結局のところ、今回公開されたのは「月の答え」ではなく、「月のデータを読むための共通の目」です。NASAの科学データ責任者ケビン・マーフィー氏は、データを集めるのは仕事の一部でしかなく、科学者が探索しやすい形にすることも同じくらい大事だ、という趣旨のことを述べています。数十年かけて溜めた観測データを、誰でも同じ土台から解析できるようにした。それが今回の公開の意味で、ここから何が見つかるかは、これを使う研究者次第です。
出典
NASA-IBM Lunar Foundation Model(Hugging Face モデルカード・技術レポートへのリンクあり)
NASA-IMPACT / NASA-IBM-Lunar-Foundation-Model(GitHub・追加学習用コード)
NASA and IBM open source lunar mapping tools(The Register・2026年9月10日)


コメント