「誰も知らない場所にある弱点は、誰にも突かれない」。セキュリティの世界では、この考え方を「隠すことによる安全(security through obscurity)」と呼びます。設計図や中身を外に見せなければ、そこにある欠陥も見つからないはずだ、という発想です。正面から推奨されたことはほとんどないのに、現場ではずっと生き残ってきました。理由は単純で、古いコードの隅々まで点検する余裕は、たいていの組織にないからです。誰も読まない部品に穴があったとしても、探す側にとっても割に合わない。その「割に合わない」が、事実上の防御になっていました。
2026年9月13日、英国のIT系メディアThe Registerのサイバーセキュリティ編集者Jessica Lyons氏が、この前提はもう成り立たないと書いています。根拠として並べられているのは、Microsoftの月例更新、米国5機関の合同勧告、そして1PasswordとVeracodeの2つの調査です。報道と評価がひとつの記事に混ざっているので、この記事ではそれぞれの一次情報を当たり直したうえで、順に見ていきます。
探す手間という壁の消滅
「割に合わない」を支えていたのは、脆弱性(ぜいじゃくせい)——プログラムに残っている、攻撃の足がかりになる弱点——を探す作業が、腕のある人間の時間を大量に食う仕事だったことです。誰も触っていない古い部品を、誰かがわざわざ読み込むことは滅多にありませんでした。
その作業をAIエージェントが肩代わりするようになって、状況が変わりました。ソフトウェア会社も独立した研究者も、AIに製品やオープンソースのコードを読ませて弱点を洗い出しています。結果として出てきたのが、9月9日にMicrosoftが1回の月例更新で974件のCVE(脆弱性に振られる識別番号)を修正した、過去最多の更新です。
数の多さそのものより、Trend MicroのZero Day Initiativeでバグ探しを率いるDustin Childs氏が挙げた「どこから出てきたか」のほうが、この話の本質を示しています。氏がThe Registerに語った例は、Telnetクライアント、Windows RNDIS、NFS Portmapper、Link Layer Topology Discoveryの4つです。Telnetは暗号化なしで遠隔操作する昔のプロトコルで、いまの業務環境で使う場面はほぼありません。RNDISはUSB経由でネットワーク接続する仕組みで、Microsoft自身が何年も前から廃止したがっていたものです。NFS Portmapperは1980年代のUnix由来、Link Layer Topology DiscoveryはWindows Vista時代にネットワーク図を描くために作られたもので、Childs氏いわく、Vista以降は誰も考えたことすらない部品です。こうした、何年も誰の話題にも上らなかった場所から、まとめて欠陥が出てきました。
FBIサイバー部門を率いるBrett Leatherman氏の見方も同じ方向です。氏がThe Registerに語ったところでは、Webサーバーの8割で動いていて、コミュニティが10年かけて叩き続け、もう安全だと信じられていたオープンソースのライブラリに対して、最新のAIモデルは「ここに重大な弱点がある」と言い当ててきたといいます。
光が入ったのは、探す側だけではありません。攻撃側もAIを使って、公開されたパッチ(修正プログラム)を逆にたどり、どこが直されたかを見つけ、そこを突く手口を数時間で組み立てるようになっています。The Registerが9月9日に別記事で報じた例では、Google Chromeなどの土台になっているオープンソースのブラウザChromiumで、開発元が修正を公開してから、その修正を組み込んだ安定版が一般ユーザーに配られるまでのわずかな時間に、少なくとも4つの諜報グループ(多くが中国との関係を疑われています)が攻撃ツールを作り上げていました。直したという事実そのものが、攻める側への地図になる時代です。
工場と水道の制御装置への波及
「隠すことによる安全」に最も長く頼ってきた分野が、工場や発電所、浄水場を動かす制御システムです。こうした設備は独自のプロトコルと専用のハードウェアで動いていて、IT技術者にとっても攻撃者にとっても中身の見えない箱でした。専門知識が一握りの人の頭の中にしかないことが、そのまま守りになっていたわけです。
2026年8月19日、米国のNSA(国家安全保障局)、CISA(サイバーセキュリティ・インフラセキュリティ庁)、FBI、エネルギー省、環境保護庁の5機関が、合同の勧告を出しました。対象はSiemensのS7シリーズと呼ばれるPLC(プログラマブル・ロジック・コントローラー。工場の機械や水処理設備を動かす制御用コンピューター)で、S7-200からS7-1500まで全世代が含まれています。狙われているのは重要製造業、エネルギー、上下水道、化学、食品・農業、商業施設といった分野です。
勧告の中身で目を引くのは、攻撃者の手口です。彼らはPLCと通信するためのオープンソースのライブラリ(snap7とpython-snap7)を土台に、AIのコーディング支援で攻撃用のスクリプトを書き、それを正規の監視ツールに見せかけて使っています。標的の探し方はCensysやZoomEyeといった公開のインターネット検索サービスで、古いソフトのまま、あるいは初期パスワードのままネットにつながっているPLCを拾い出す、というものです。勧告は、AIで攻撃スクリプトを作れるようになったことで、制御システムを攻めるのに必要だった専門知識と時間が大幅に減ったと明記し、これは理論上のリスクではなく現に進行中の脅威だと述べています。勧告はどの国や組織の仕業かを特定していません。勧告が述べているのは「偵察と攻撃能力の開発が行われている」ことで、どこかの設備が実際に乗っ取られたとまでは書かれていない点は、押さえておく必要があります。
Google Threat Intelligence Groupで主席アナリストを務めるJohn Hultquist氏は、The Registerに、AIは技術的なトラブルシューティングが得意で、マイナーなシステムのことも知っていて、手順を一緒にたどってくれる、だから制御システムがとても心配だと語っています。専門知識が一握りの人の頭の中にあるからこそ守られてきたが、それは永遠には続かない、という見立てです。
直す側のAIが抱える成功率の問題
ここまでは、AIが攻める側と探す側の両方を速くした、という話でした。ならば直す側もAIで速くすればいい、というのが自然な発想です。実際、AIにパッチを書かせる取り組みは各所で始まっています。ところがその効き目を測った調査が、この夏に2つ出ていて、どちらも芳しくない数字を示しました。
1つ目は、パスワード管理ツールで知られる1Passwordが2026年8月6日に公表した研究です。同社の新設した研究チームOff-by-1 Labsが、2026年3月以降に公表された6件の脆弱性を対象に、OpenAIのChatGPT-5.5とAnthropicのClaude Opus 4.8という2つのモデルに合計6,080本のパッチを書かせました。対象を最近の脆弱性に絞ったのは、モデルが学習データの中で正解のパッチを見ていない状態で試すためです。1つの脆弱性につき1モデルあたり540本、環境の設定を3通り、指示の書き方を9通りに変えて生成させています。
結果は、脆弱性を完全に塞ぎ、しかもアプリの挙動を変えなかったパッチが平均26.0%。塞いだものの挙動を変えてしまったパッチが20.1%。そして、塞げなかったか、新しい脆弱性を持ち込んだか、その両方だったパッチが53.9%でした。研究チームは事前に「オープンソースのコードなら7割近く成功するだろう」と見込んでいたのですが、実際はその半分以下だったことになります。
数字以上に気になるのは、成功に分類されたパッチの中身です。研究責任者のKeith Hoodlet氏によると、成功したパッチの3分の1以上が、根本原因を直さずに、手元の実証コードで使われた特定の入力だけを弾く「もろい」修正でした。別の入力で同じ経路に到達できれば、古い脆弱性がそのまま復活します。氏が挙げた例では、あるJavaフレームワークの脆弱性に対して、どちらのモデルも、ユーザー入力の特定の文字を無害化するだけのパッチを繰り返し出してきたそうです。試験に使った実証コードは止まるので、一見すると直ったように見えます。
2つ目は、アプリケーションのセキュリティ検査を手がけるVeracodeが7月28日に出した年次報告です。こちらはパッチではなく、AIにコードを書かせたときに安全性の検査を通る割合を、4年にわたり100以上のモデルで測っています。平均は56%で、前年からほぼ動いていません。最新の11モデルを80の課題で試した結果でも、最高だったGPT-5.5で68%、11モデルのうち6つが50〜53%に固まっています。文法的に正しいコードはほぼ100%書けるのに、セキュリティが絡む課題では4割強で穴を作る、という状態が続いています。
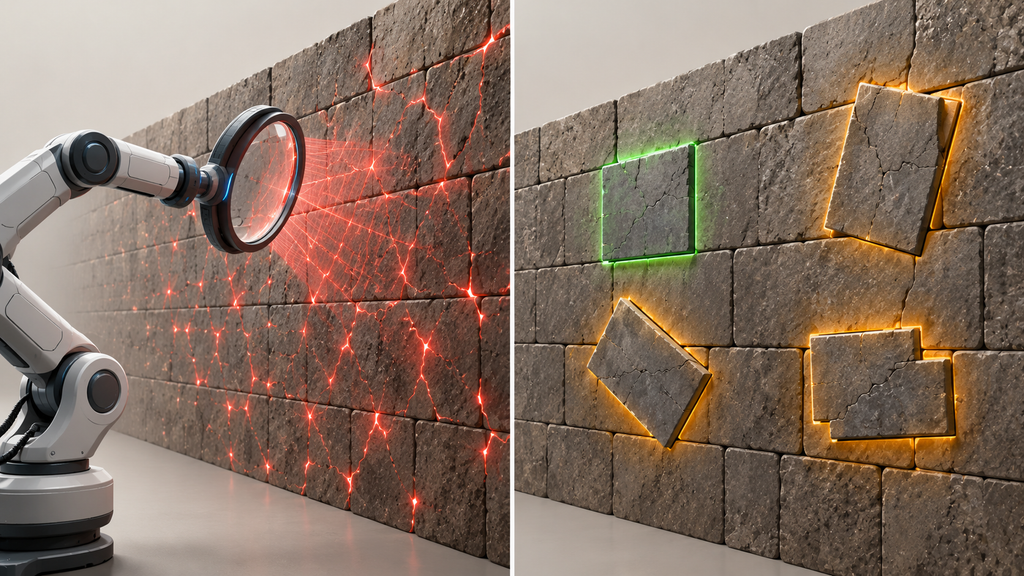
見つける側と攻める側では、AIは何年分もの人手を一気に置き換えました。直す側では、4本に1本しか当たらず、当たったものの3分の1は根本を直していない。この非対称が、いまのセキュリティの現在地です。バグ報奨金制度の草分けとして知られるLuta Security創業者のKatie Moussouris氏は、The Registerに、AIはセキュリティの絵の間違った端に強い光を当てている、AIによる自動修正はまだそこまで来ていない、と語っています。氏の見方では、弱点を見つけること自体は昔から最大の問題ではありませんでした。難しいのは、見つかったものに優先順位をつけて、実際に直しきることです。
数を追う修正からの転換
The Registerの記事は、それでも「隠すことによる安全」が葬られたこと自体は悪いことではない、という立場です。Moussouris氏は長くハッカーとして活動してきた立場から、この考え方は最初から勝てる戦略ではなかったと言います。誰かがあなたの組織に目を向けると決めた瞬間に、そこに見つかるものがあれば見つかる。AIが変えたのは、その「目を向ける」ことの敷居です。相手が使っている技術に詳しくなくても、AIがすでにそれを飲み込んでいるので、弱点の洗い出しはAIがやってくれる。氏はそう説明しています。
では守る側は何をすればいいのか。Moussouris氏の答えは、見つけて直す速さを競うことではありません。氏は、人手を増やして見つけては直すを繰り返すだけで、そもそもなぜこれだけのバグが生まれたのかという工程の問題に投資しない組織は、ランニングマシンの上で息切れして倒れる、という言い方をしています。代わりに勧めているのは、見つかった脆弱性の「種類」を見ることです。たとえば入力の扱いに起因する欠陥が多いと分かれば、開発工程の早い段階で安全な雛形を用意することで、その種類ごとまとめて防げる。1件ずつ速く直すより、そちらのほうが効く、という考え方です。
個人の側でできることは、以前と変わりません。更新の通知が来たら当てる、それだけです。修正の数がどれだけ増えても、直したという公開情報が数時間で攻撃の地図になる以上、当てる前の時間が最も危険な時間帯であることは変わりません。Chromiumの例は、まさにその隙間を突かれた話でした。
最後に、このブログの立場について書いておきます。この記事を含め、うちの記事はAnthropicのClaudeを使って書いています。上で紹介した1Passwordの研究で試されたモデルの片方は、そのAnthropicのClaude Opus 4.8です。AIでコードを書いたり直したりする話題では、うちは当事者の側にいます。それを踏まえたうえで、数字はそのまま書きました。4本に1本という成功率は、AIにパッチを書かせる立場からしても、人の目を外せる段階ではないことを示しています。1Passwordの研究では、Anthropic側からのフィードバックとして、現在の能力では専門家が最終確認に残るべきだという趣旨のコメントも掲載されています。
出典
Security through obscurity is dead, and AI delivered the fatal blow(The Register、2026年9月13日)
2026 GenAI Code Security Report(Veracode)
Defending Against an Active Threat to Siemens S7 Series PLCs(合同勧告AA26-231A、CISA、2026年8月19日)
Siemens S7 PLC threat: What you need to know — 合同勧告AA26-231Aの解説(Tenable)
Microsoft breaks Patch Tuesday record with 974-CVE deluge(The Register、2026年9月9日)

コメント